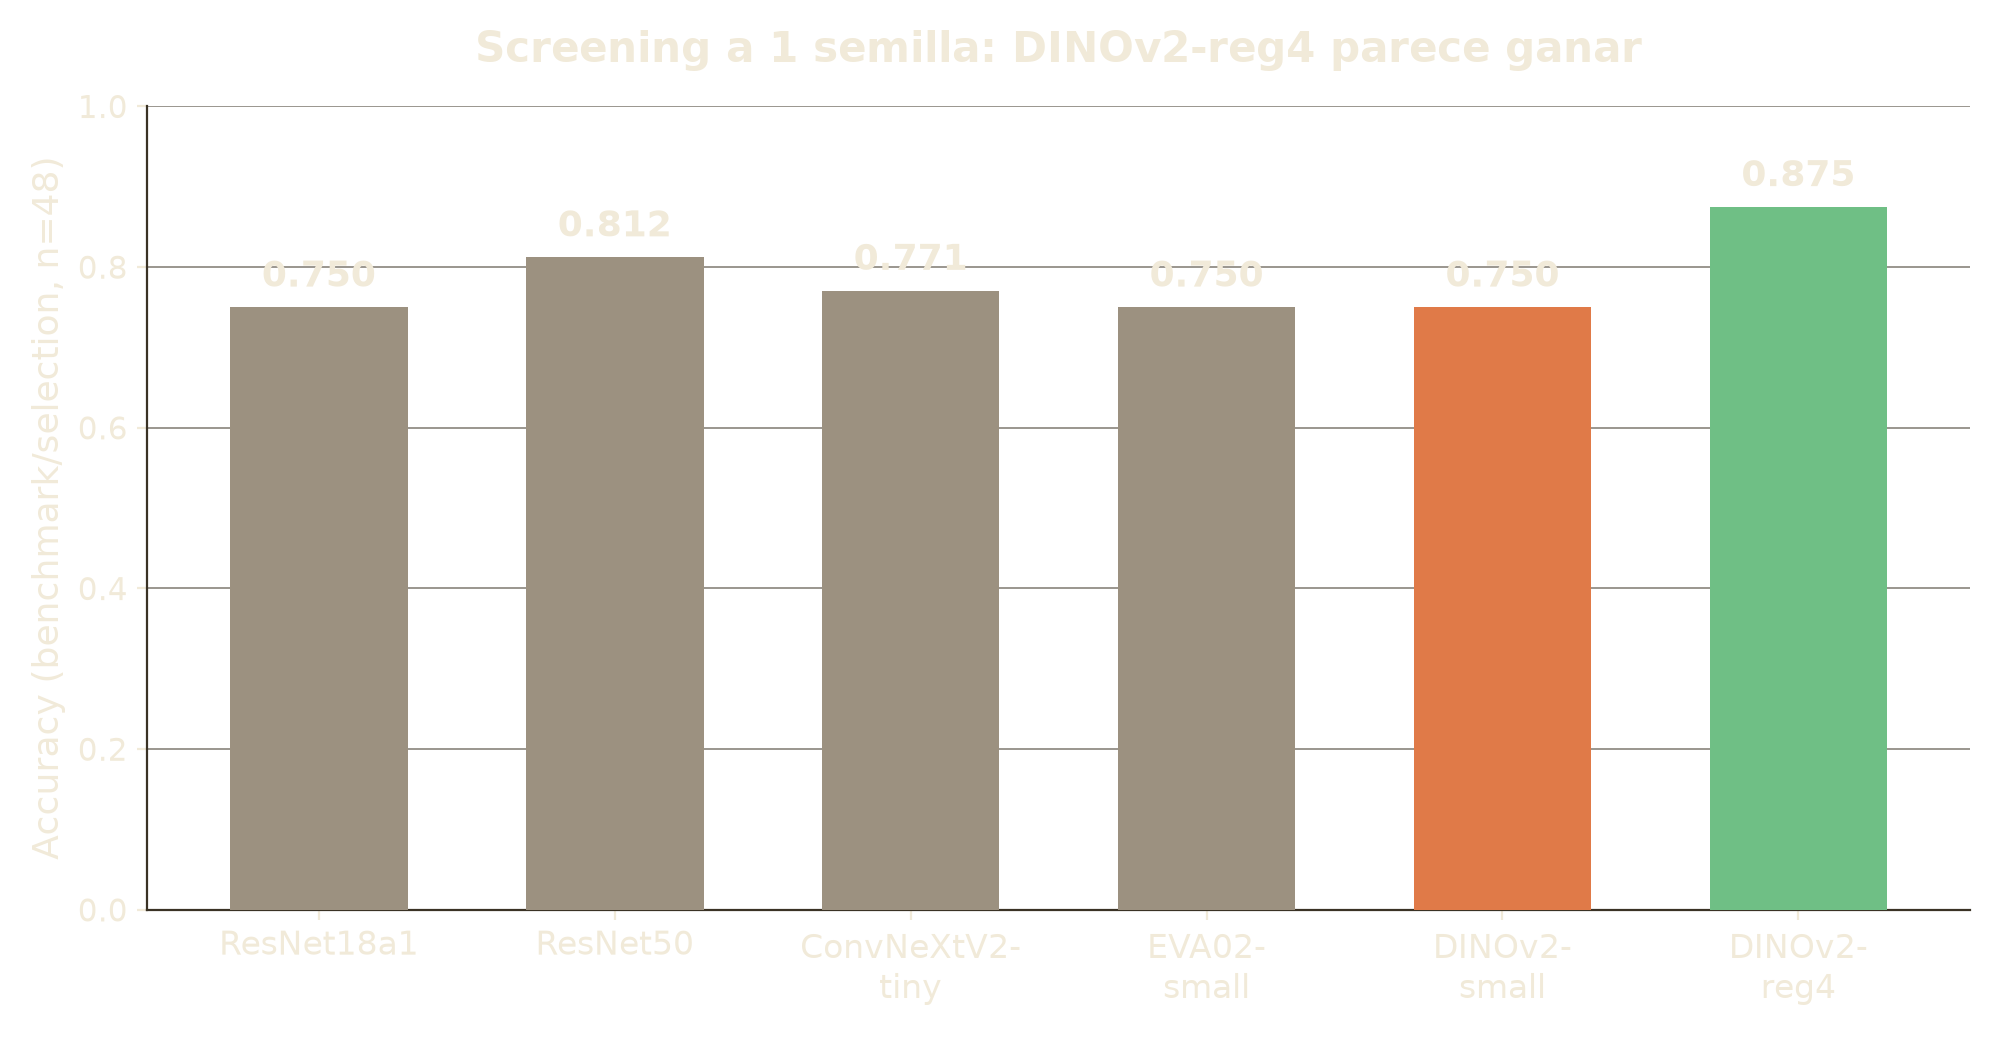import bpy

def add_bone_rigid_body(obj):
    bpy.context.view_layer.objects.active = obj
    bpy.ops.rigidbody.object_add(type="ACTIVE")
    # MESH exacto: una costilla rueda como una mecedora
    obj.rigid_body.collision_shape = "CONVEX_HULL"
    obj.rigid_body.friction = 0.6
    obj.rigid_body.angular_damping = 0.45
Sin UI:--background, un proceso por espécimen lanzado con subprocess.run.
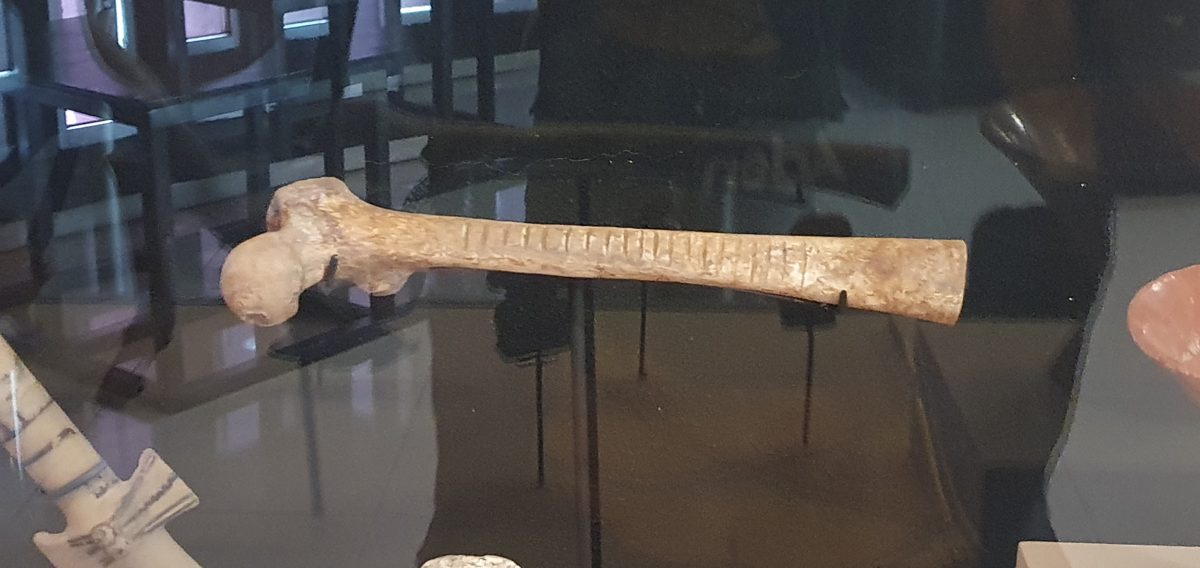
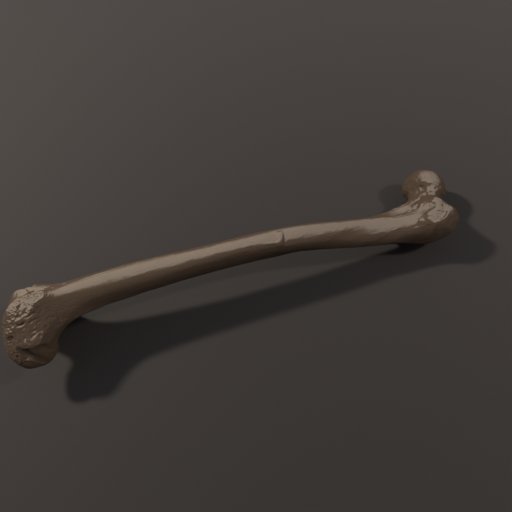
Física real: el hueso se suelta sobre la mesa; su postura es la que tendría en la vida real.
121/121 especímenes sin fallos → 726 imágenes con máscara.
Datos sintéticos
Centrar el objeto, repartir cámaras, mirar al centro
def fibonacci_sphere(n, radius):
    """Direcciones bien repartidas en la esfera -- no
    vistas al azar, que se amontonan en los polos."""
    points = []
    phi = math.pi * (3.0 - math.sqrt(5.0))
    for i in range(n):
        y = 1 - (i / max(n - 1, 1)) * 2
        r = math.sqrt(max(0.0, 1 - y * y))
        theta = phi * i
        points.append(Vector((math.cos(theta)*r, y,
                               math.sin(theta)*r)) * radius)
    return points

def look_at_matrix(cam_location, target):
    direction = target - cam_location
    rot = direction.to_track_quat("-Z", "Y")
    mat = rot.to_matrix().to_4x4()
    mat.translation = cam_location
    return mat

# centro en espacio de MUNDO: no se mueve el objeto
# (evita mover padre+hijos del glTF dos veces)
center = Vector(all_verts_world.mean(axis=0))

for i, direction in enumerate(fibonacci_sphere(n_views, 1.0)):
    cam_location = center + direction * distance
    cam.matrix_world = look_at_matrix(cam_location, center)
Centro en mundo, no en el objeto: la jerarquía del glTF tiene padres e hijos; mover el objeto los desplaza dos veces.
Fibonacci sphere: vistas repartidas uniformemente, no un muestreo al azar que amontona cámaras en los polos.
Distancia por focal: 24-70mm variable → cada vista recalcula la distancia para que el hueso llene el fill objetivo del encuadre.
Entre vista y vista también cambia el HDRI y se reaplica la suciedad procedural: "dar vueltas" es también cambiar la escena, no solo la cámara.
Datos sintéticos
La física falla en silencio
def normalize_scale(obj):
    """Las mallas NO comparten escala (costilla r≈2,
    fémur≈12, escápula≈106). A escala grande el solver
    falla EN SILENCIO: el hueso se queda flotando."""
    _, radius = local_bbox_radius(obj)
    factor = TARGET_RADIUS / radius
    obj.scale = (factor, factor, factor)
    bpy.context.view_layer.objects.active = obj
    bpy.ops.object.transform_apply(
        location=False, rotation=False, scale=True)
Síntoma
Causa
Hueso flotando a media caída
escala 2 – 106 unidades
Costilla rodando sin parar
colisión MESH inestable
Sin sombra de contacto
margen de colisión del solver
Imagen plana, sin volumen
luces iguales se cancelan
Hueso "de plástico"
rugosidad baja en el PBR
Ningún test lo detectaba. Lo detectó mirar las imágenes: un visor en Streamlit y un contact sheet por lote.
El hueco sintético → real
El modelo aprendió a reconocer renders
77%accuracy en renders
vs
27%accuracy en fotos reales
Si tu test comparte distribución con el entrenamiento, tu test es optimista por construcción. Necesitas un examen con datos del mundo real, apartado desde el día 1.
El mayor salto
12 fotos reales pesaron más que toda la síntesis
0.3%del dataset eran fotos reales… y movieron más la aguja que cualquier mejora de render.
Problema: dentro de cada grupo, lo real es minoría (costilla: 5% de sus filas). Solución con PyTorch:
from torch.utils.data import WeightedRandomSampler

is_real = (train_df["source_path"]
           .str.startswith("data/real_photos_accepted/")
           .to_numpy())
weights = np.where(is_real, args.real_photo_boost, 1.0)

sampler = WeightedRandomSampler(
    weights=torch.as_tensor(weights, dtype=torch.double),
    num_samples=len(train_dataset),
    replacement=True,
)
# el balance ENTRE grupos sigue en la pérdida:
# class_weight="balanced"
Sintético para arrancar, real para llegar. Hoy: 357+ fotos reales curadas, con un examen fijo aparte que nunca entrena.
Features clásicas
Medir la forma con NumPy
def _axis_shape_features(centerline):
    pts = np.asarray(centerline, dtype=np.float64)
    chord = np.linalg.norm(pts[-1] - pts[0])
    arc = np.sum(np.linalg.norm(np.diff(pts, axis=0), axis=1))
    tortuosity = arc / chord          # 1.0 = recto

    angles = [_signed_turning_angle(*pts[i - 1:i + 2])
              for i in range(1, len(pts) - 1)]
    total = sum(abs(a) for a in angles)
    # 1.0 = gira siempre al mismo lado (arco, costilla)
    # 0.0 = se cancela (recta con ruido)
    consistency = abs(sum(angles)) / total
    return tortuosity, total, consistency
Del contorno (OpenCV) salen medidas invariantes a escala:
elongacióncircularidadsolidezmomentos de Huperfil de anchuraagujerostortuosidadajuste a arco
→ RandomForestClassifier: rápido, explicable, y la base del híbrido.
Costilla vs hueso largo: los dos son "alargados". La diferencia es que una se curva siempre hacia el mismo lado.
Segmentación
El problema no era medir: era encontrar el hueso
antes
Umbral tipo Otsu
Funciona en fondo blanco. En una vitrina con reflejos, segmenta el cristal.
después
Grounded-SAM
Texto "bone" → caja con Grounding DINO → máscara con SAM. Mejora notable en geométrico e híbrido.
multi-instancia
Una foto, 24 costillas
Todas las cajas → una máscara por hueso → resto en gris. 42 recortes, 28 limpios.
recall de costilla0.25→0.89
Deep learning
Primera CNN
9 grupos
Cráneo
Costillas
Vértebras
Huesos largos
Pelvis
Sacro
Huesos cortos
Huesos planos
Mandíbula-maxilar
Dataset
3D
↓
3653 imágenes sintéticas (122 huesos 3D)
+
75 imágenes reales (examen, 0% en train)
↓↓
total = 3728 imágenes
Red Neuronal
224²
×3 canales
↓
resnet18
Lineal 512→128 + ReLU + Dropout Lineal 128→9
Resultado
Acc
0.671
Recall
0.47
F1
0.46
Precision
0.50
Matriz de confusión
Deep learning · reproducido con código y dataset originales (commit 53fe6e3)
El primer experimento, completo
Primera vez que se mete una red neuronal: resnet18 preentrenada + cabeza propia, entrenada en 2 fases desde el primer commit. A la derecha, el resultado desglosado por clase — no solo el agregado que quedó escrito en su momento.
Arquitectura: backbone congelado primero (no destrozar los pesos de ImageNet con una cabeza sin entrenar), luego descongelado a LR muy bajo.
100% sintético en entrenamiento — las fotos reales nunca entran, solo examinan al final. Split por espécimen (GroupShuffleSplit), no por fila: ningún hueso físico repite entre train y val.
Validación (672 filas, especímenes nunca entrenados): desglose por clase que el log original de 2026-07-25 no guardó, solo el agregado.
grupo (val)
prec.
rec.
F1
n
costilla
0.91
0.43
0.59
136
cranio
0.84
0.78
0.81
78
hueso_largo
0.51
0.83
0.63
54
hueso_pequeno
0.82
0.88
0.85
235
hueso_plano
0.46
0.53
0.49
101
mandibula_maxilar
0.40
0.06
0.10
34
pelvis
0 filas en este split
0
sacro
0 filas en este split
0
vertebra
0.60
0.74
0.66
34
accuracy
0.671
672
macro avg
0.50
0.47
0.46
672
weighted avg
0.73
0.67
0.67
672
banco limpio (9 espec. nunca vistos)
prec.
rec.
F1
accuracy global
0.731 (216 filas, 24/grupo)
mejor: hueso_pequeno
0.77
1.00
0.87
peor: costilla
0.42
0.33
0.37
Confusión principal: mandibula_maxilar→sacro 14/34 (41%) — la más rara, sin relación morfológica; hueso_plano↔hueso_pequeno se pisan en ambas direcciones (24 y 12 filas), probable falta de escala de referencia en el recorte.
Reentrenado hoy con el código y los 3653 renders originales (commit 53fe6e3, MLflow+DVC) para sacar la matriz de confusión y el F1 que en 2026-07-25 solo quedaron como recall agregado.
resnet18, transfer learning en 2 fases: cabeza congelada 8 épocas, fine-tune 15 más a LR bajo.
GPU RTX 4080: 23 épocas en ~3-4 min.
Mismo split espécimen-fuera y mismos 3 bancos que el modelo geométrico, para comparar de verdad.
Interno
Banco limpio
Fotos reales
Geométrico
0.645
0.773
0.267
CNN sola
0.683
0.755
0.493
Híbrido (concat)
0.701
0.810
0.133
El híbrido ingenuo gana en los dos bancos sintéticos y se desploma en fotos reales (predice sacro casi siempre): aprendió a fiarse de las features geométricas, limpias en render, distorsionadas en foto real.
ResNet18 preentrenada con timm, sobre el recorte segmentado.
Fase 1: backbone congelado, solo la cabeza.
Fase 2: fine-tuning completo con learning rate bajo.
Las features geométricas se escalan con StandardScaler antes del cat.
recall
forma
textura
hueso largo
0.88
0.38
vértebra
0.14
0.71
cráneo
0.00
0.57
Bajar de nivel
¿Fémur o húmero? Cascada, no más clases
# grupo de etapa 1 → modelo que afina dentro del grupo
STAGE2_MODELS = {
    "hueso_largo":   "stage2_hueso_largo",   # fémur/húmero/otro
    "hueso_pequeno": "stage2_hueso_pequeno", # astrágalo/otro
    "vertebra":      "stage2_vertebra",      # cervical/torácica/lumbar
}
STAGE2_TAXON_MODELS = {
    "cranio": "stage2_taxon_cranio",  # humano/carnívoro/ungulado/roedor
    "mandibula_maxilar": "stage2_taxon_mandibula_maxilar",
}
Plano 12 clases
Cascada 2 etapas
Accuracy
0.753
0.818
Balanced acc.
0.663
0.736
hueso plano (recall)
0.00
0.25
húmero (recall)
0.43
0.86
Meter todo en un clasificador plano hizo que clases no relacionadas se pisaran: hueso plano colapsó a 0 sin tocar sus datos.
Evaluar sin engañarte · 1
24 vistas del mismo fémur = examen con chuleta
from sklearn.model_selection import StratifiedGroupKFold

def subject_ids(df):
    # "specimen" solo puede colisionar entre colecciones
    return (df["species"].astype(str).str.strip() + "::"
            + df["specimen"].astype(str).str.strip()).to_numpy()

def subject_holdout(df, target_col, test_size=0.2, random_state=42):
    splitter = StratifiedGroupKFold(
        n_splits=round(1 / test_size), shuffle=True,
        random_state=random_state)
    train_idx, val_idx = next(splitter.split(
        df, y=df[target_col], groups=subject_ids(df)))
    train_df, val_df = df.iloc[train_idx], df.iloc[val_idx]
    overlap = set(subject_ids(train_df)) & set(subject_ids(val_df))
    if overlap:
        raise RuntimeError(f"Fuga de sujeto: {sorted(overlap)}")
    return train_df, val_df
train_test_split por fila reparte vistas del mismo hueso a ambos lados.
Agrupa por sujeto, estratifica por clase: StratifiedGroupKFold.
Falla ruidosamente: un RuntimeError vale más que un aviso en un log.
Con tests en pytest. 4343 filas, 418 sujetos, 0 compartidos.
Evaluar sin engañarte · 2
Accuracy esconde clases enteras
Geométrico
Accuracy
0.544
Macro-F1
0.47
Recall de costilla
0.00
Con 8.5× de desbalance, puedes acertar mucho en las clases grandes e ignorar una entera.
from sklearn.metrics import balanced_accuracy_score
# media del recall de cada clase
balanced_accuracy_score(y_true, y_pred)
🐛 Bug de regalo: la clase fantasma
# guardarraíl: ninguna clase con recall 0
recall_score(y_val, preds, labels=range(n_classes),
             average=None, zero_division=0)
# clase sin filas en val → recall 0 SIEMPRE
# → el guardarraíl saltaba en todas las epochs

recall_score(y_val, preds, labels=np.unique(y_val),
             average=None, zero_division=0)   # ✅
mandíbula/maxilar: 11 especímenes, ninguno cayó en val con esa semilla.
Evaluar sin engañarte · 3
0.844 → 0.870. ¿Lo celebramos?
from scipy.stats import binomtest
# McNemar exacto: solo cuentan las fotos donde discrepan
mejora, empeora = 5, 3            # de 77 fotos
binomtest(empeora, mejora + empeora, 0.5).pvalue
# 0.727  → no significativo
Bootstrap pareado (10 000 remuestreos): IC 95% de la diferencia [−3.9%, +9.1%]. Cruza el cero.
Lo correcto: 3 semillas contra 3 semillas, balanced accuracy:
semilla
anterior
render lab
42
0.796
0.832
1
0.793
0.831
7
0.804
0.824
Accuracy cruda: rangos solapados. Balanced: sin solape. Ahí sí hay mejora.
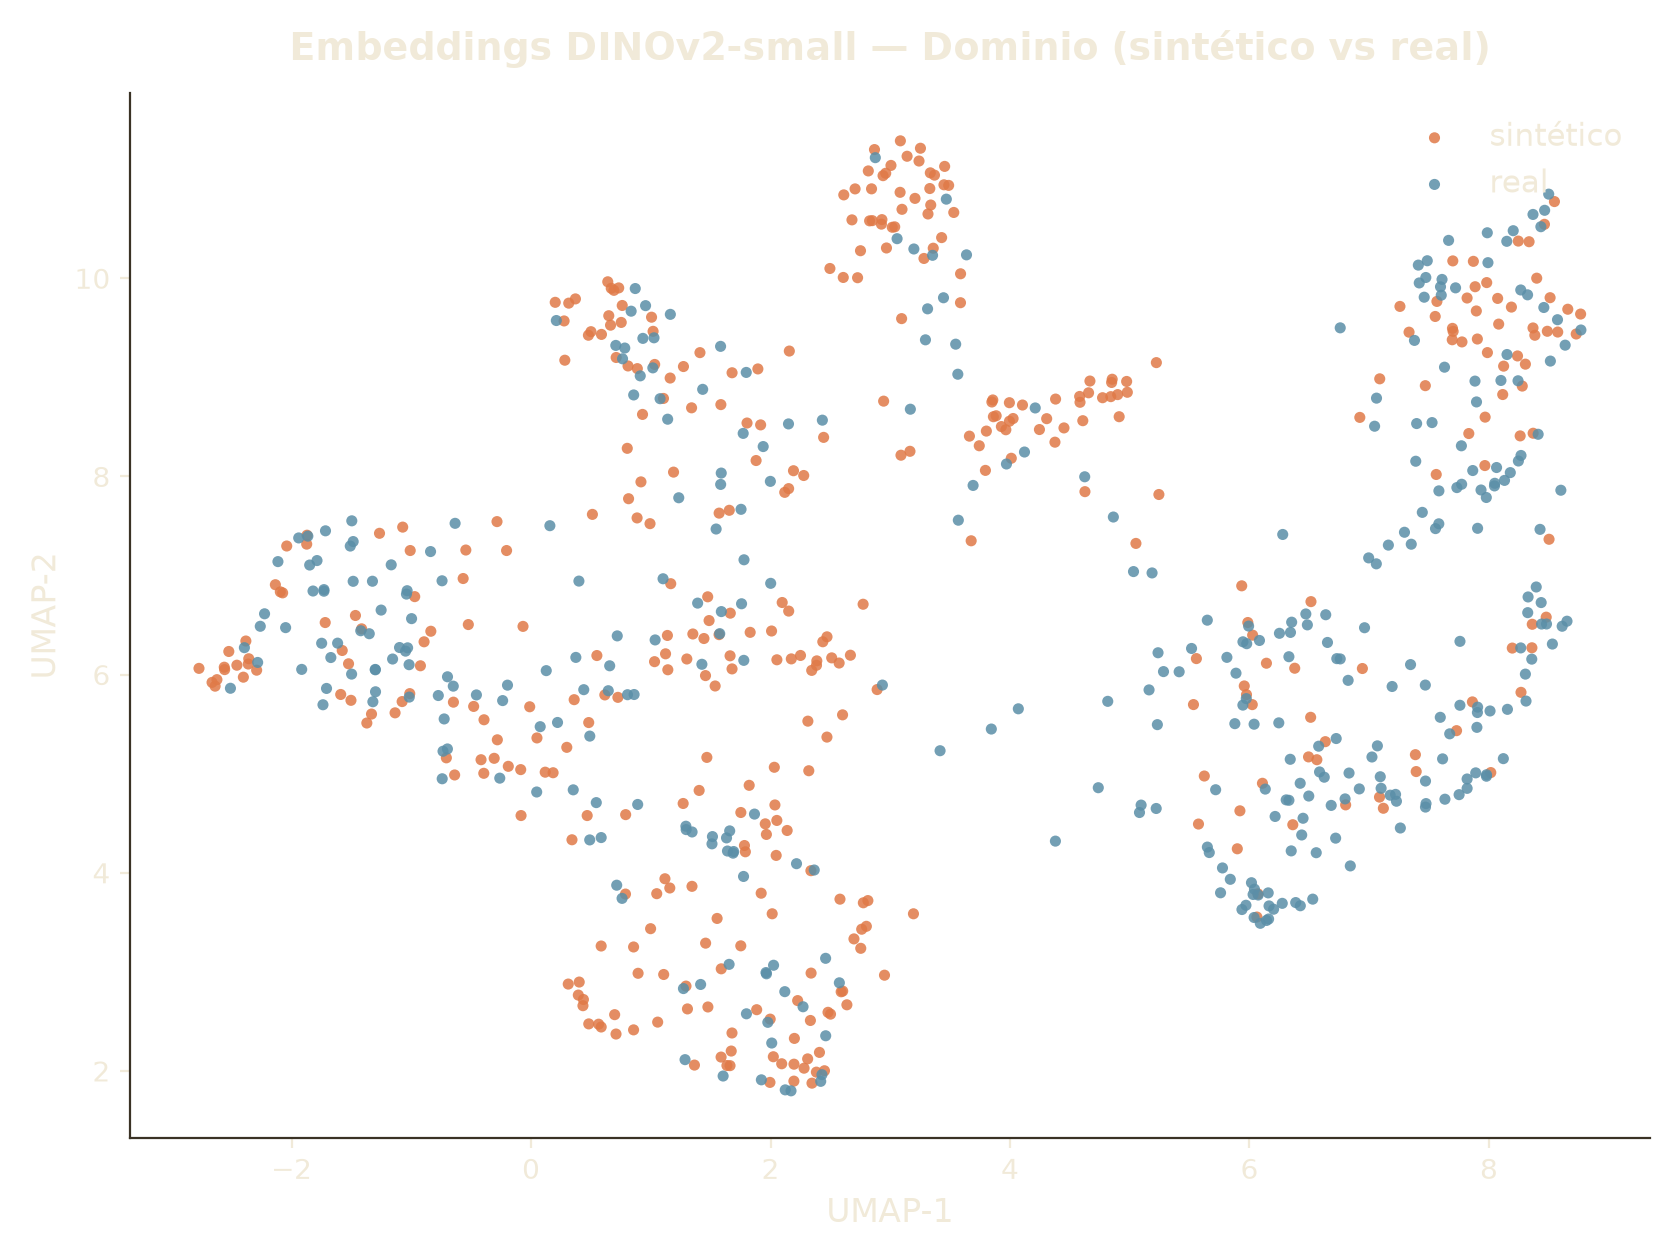
¿Lo que aprende con imágenes sintéticas funciona con fotografías reales?
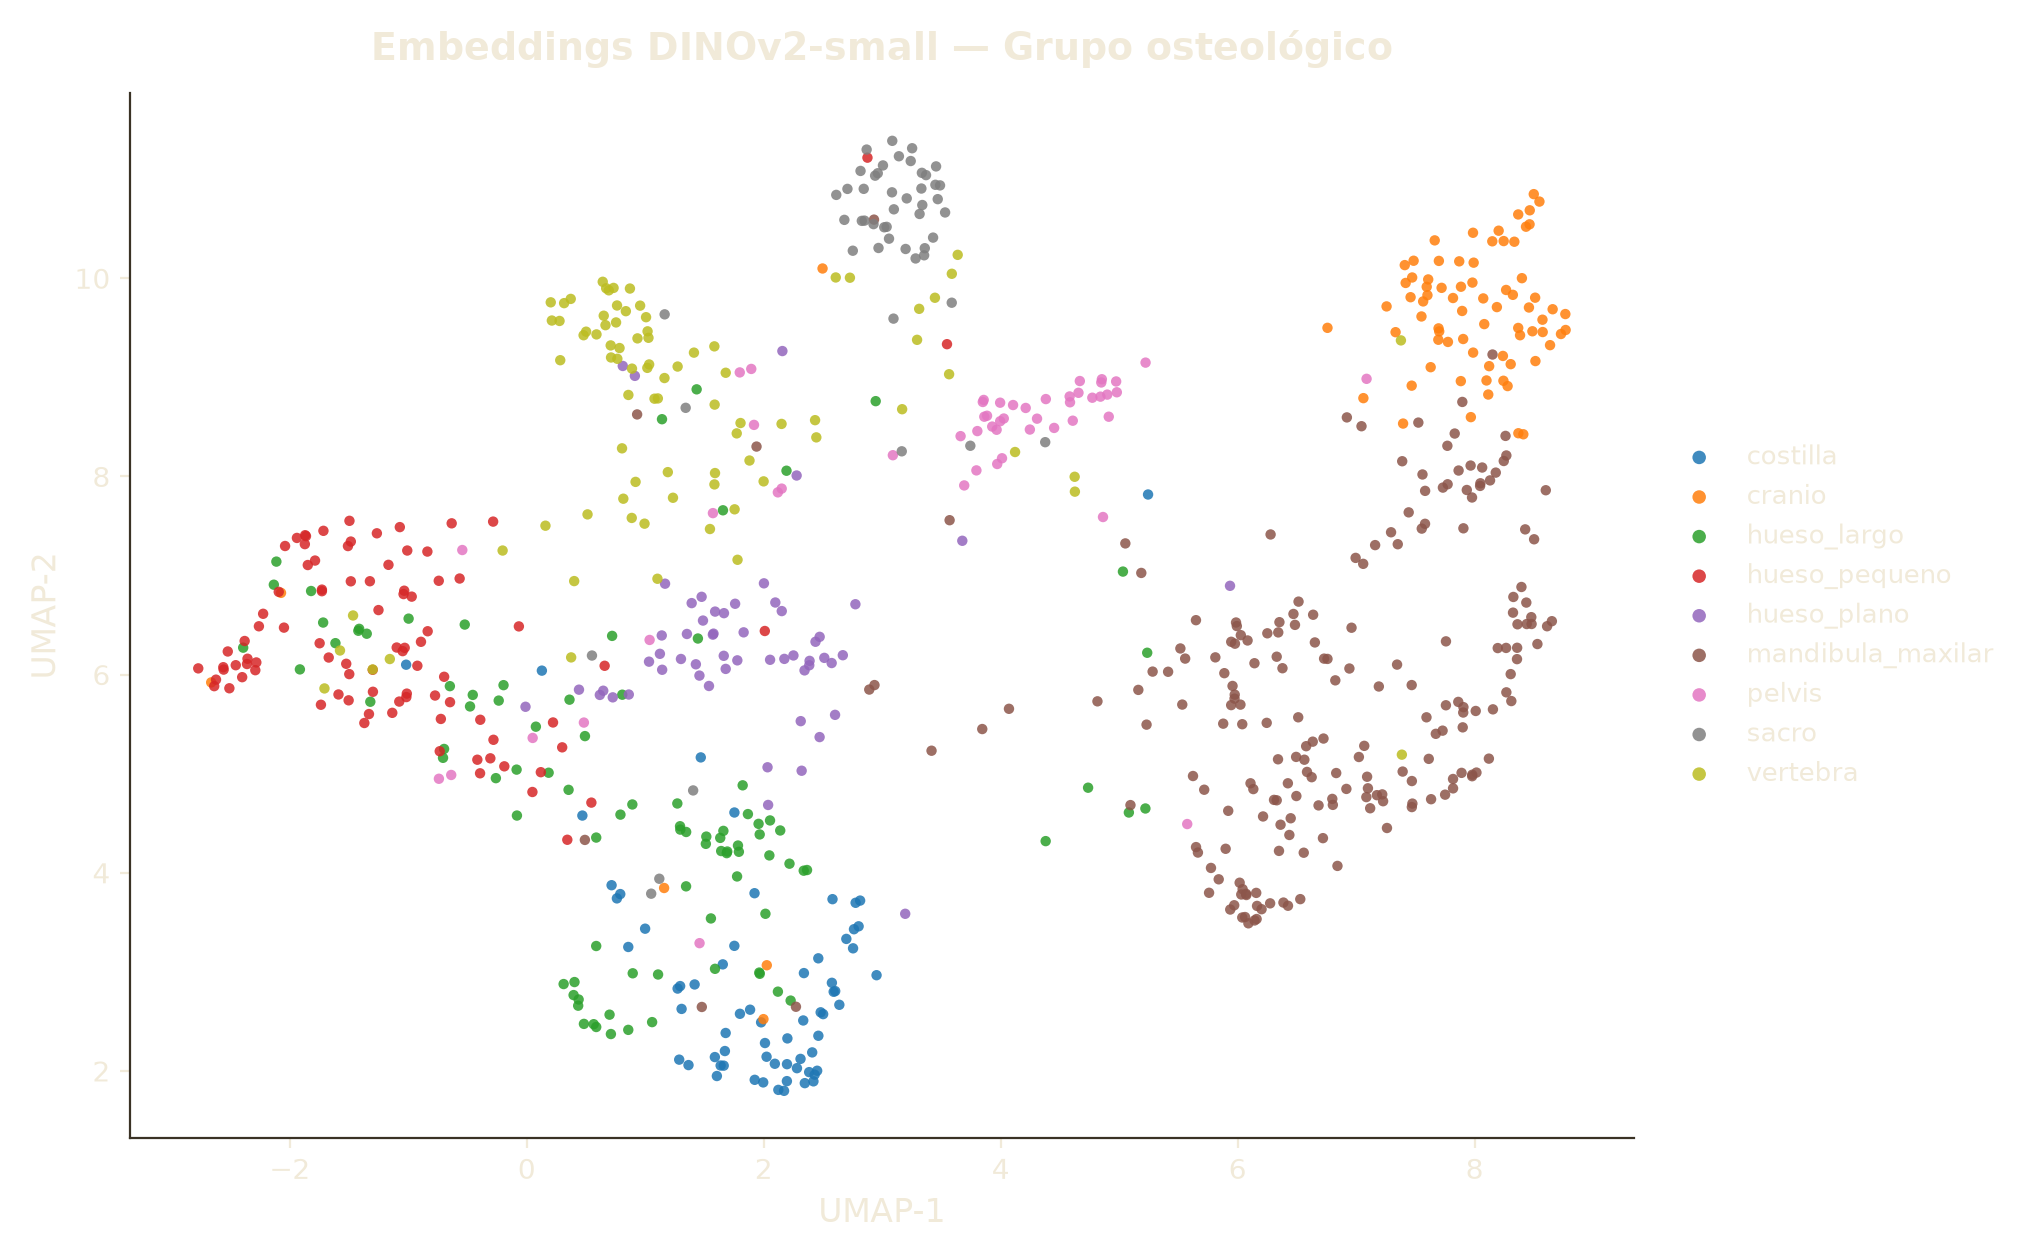
El espacio de embeddings mezcla dominio, pero organiza anatomía
Coloreado por dominio. Sintético y real se mezclan dentro de cada isla — no hay dos nubes separadas. Mixing score 0.631 vs 0.501 esperado si mezcla perfecta: queda gap, pero no domina la estructura.Mismo embedding, coloreado por grupo óseo. Las 9 clases se organizan en regiones reconocibles — el espacio aprende anatomía, no solo "¿render o foto?".
Conjunto
Accuracy
Balanced acc.
Validación sintética
0.786
—
Test real no visto (n=48)
0.896
0.876
Mismo modelo (hybrid_lab_dinov2s_seed7, producción). No es caída de dominio — en este examen concreto el modelo rinde mejor en real que en su propia validación sintética. Balanced accuracy sintética y macro-F1 de ambos: no quedaron logueados, no se inventan aquí.
¿Cuánto acierta y dónde falla?
Sistema completo en producción, contra 48 fotos externas nunca vistas
Accuracy
Balanced acc.
Macro-F1
Top-3
0.854
0.841
0.84
0.957
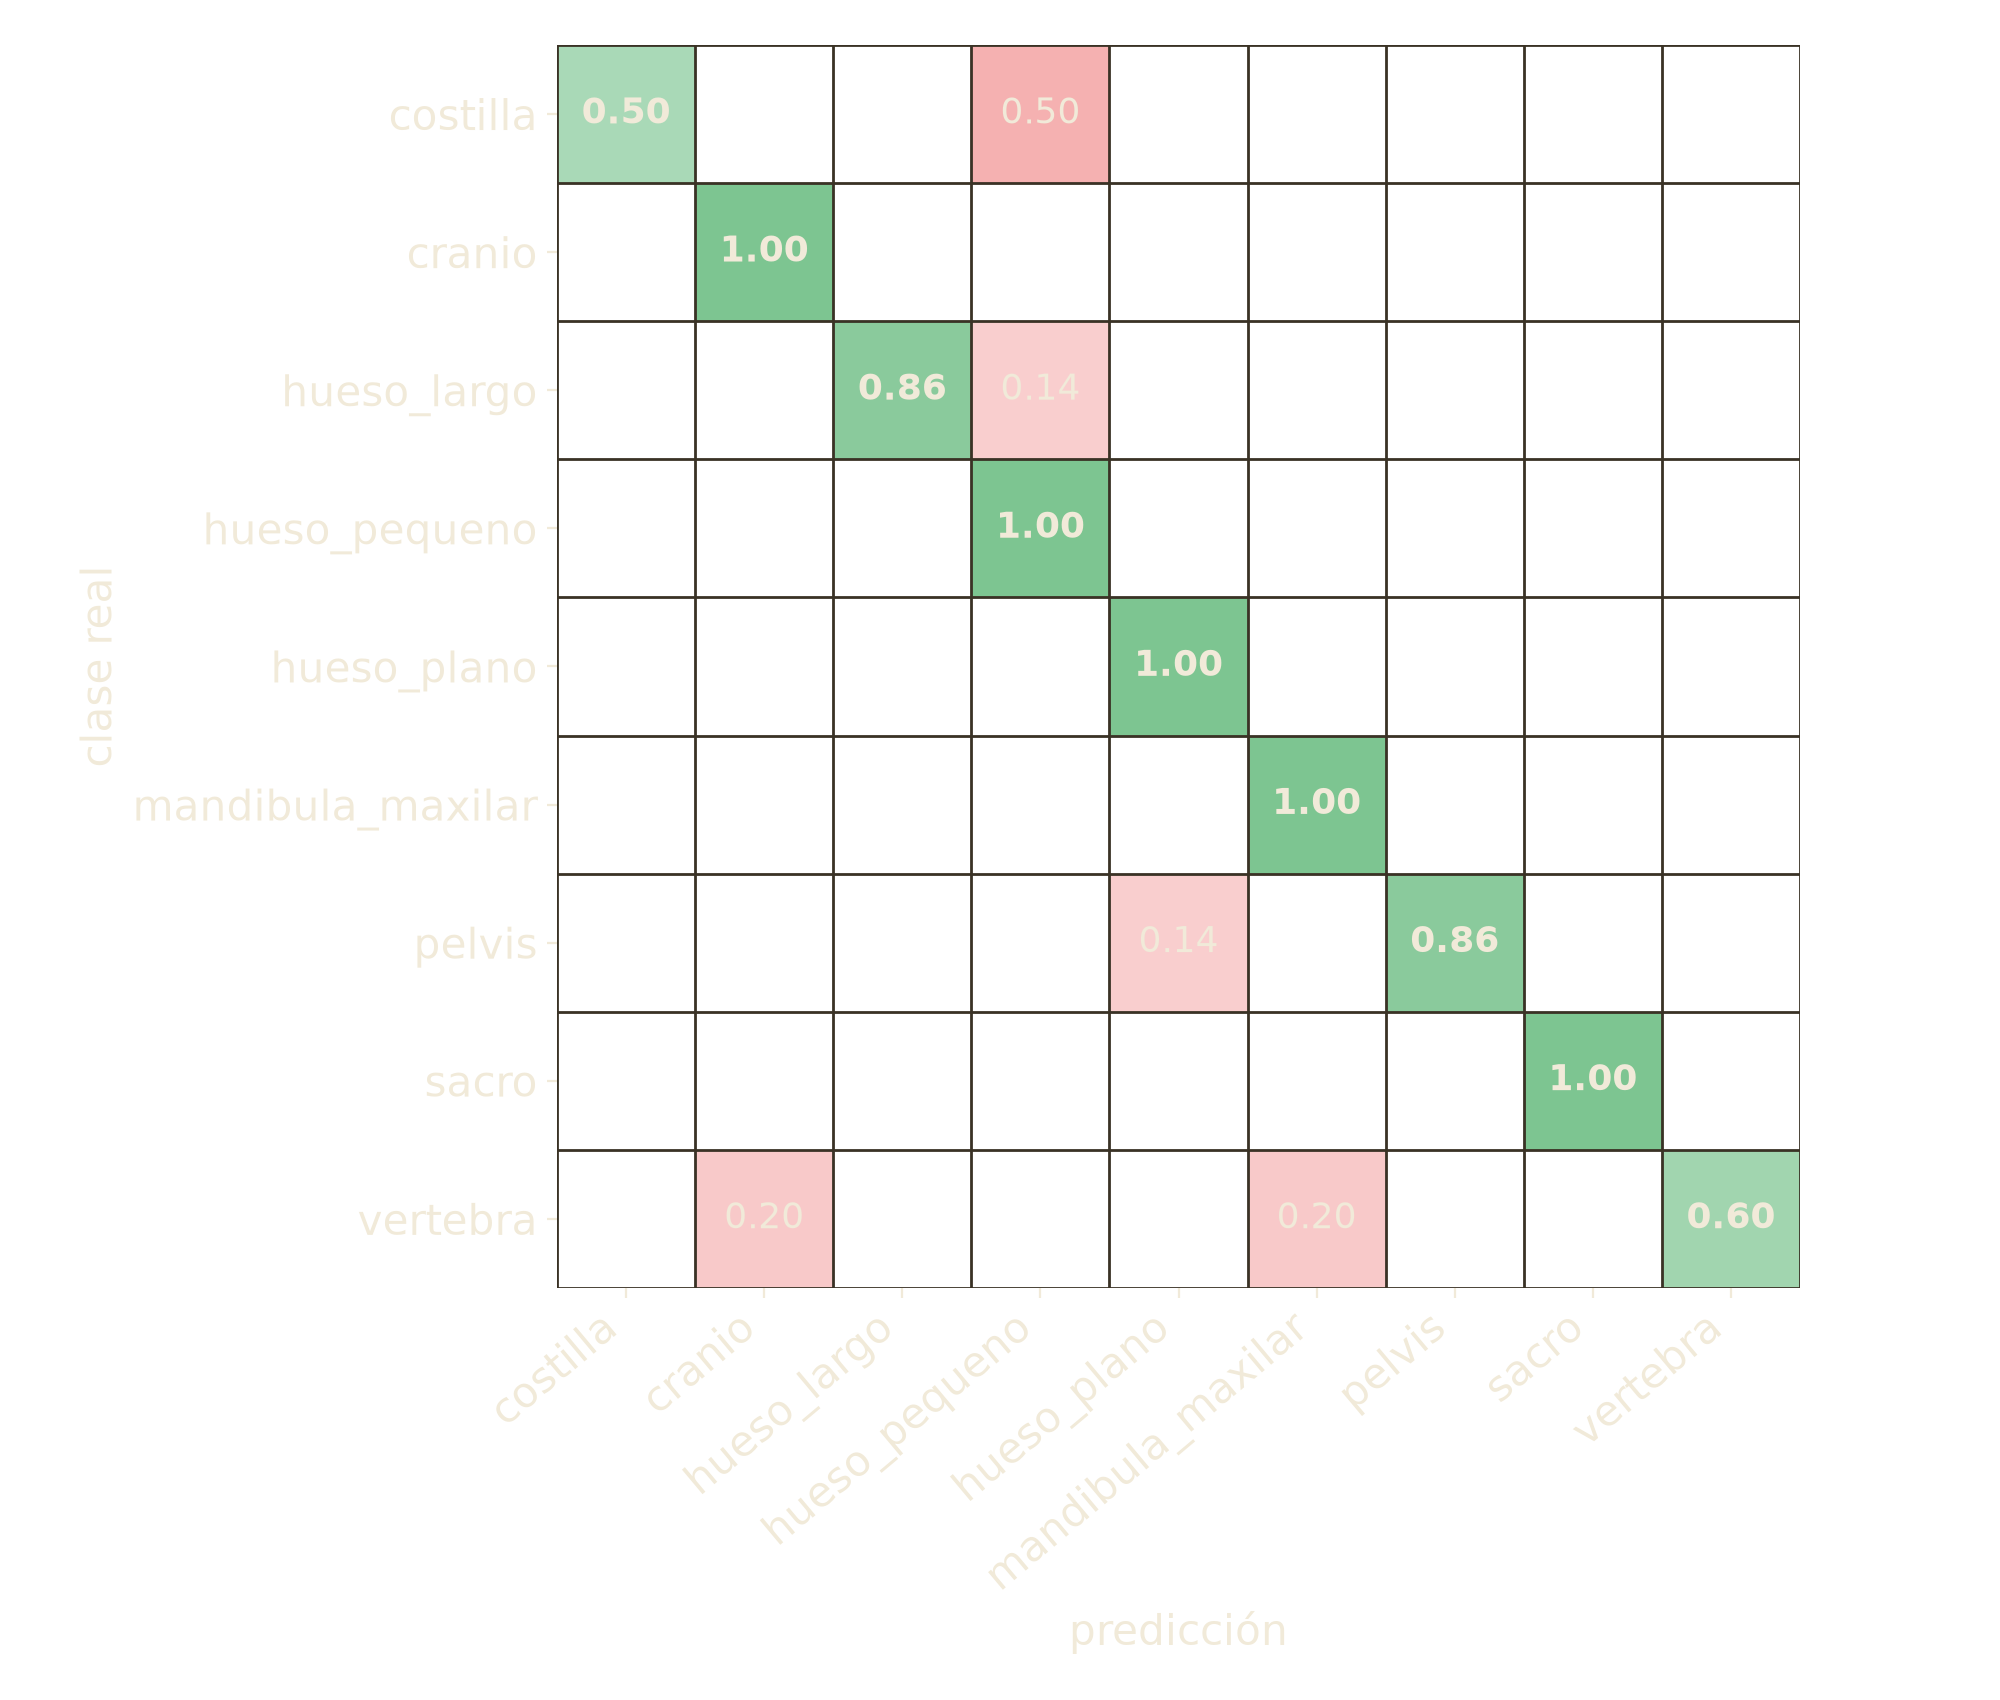
Pipeline entero (segmentación + clasificación), banco externo real_world_benchmark, no el dataset de entrenamiento.
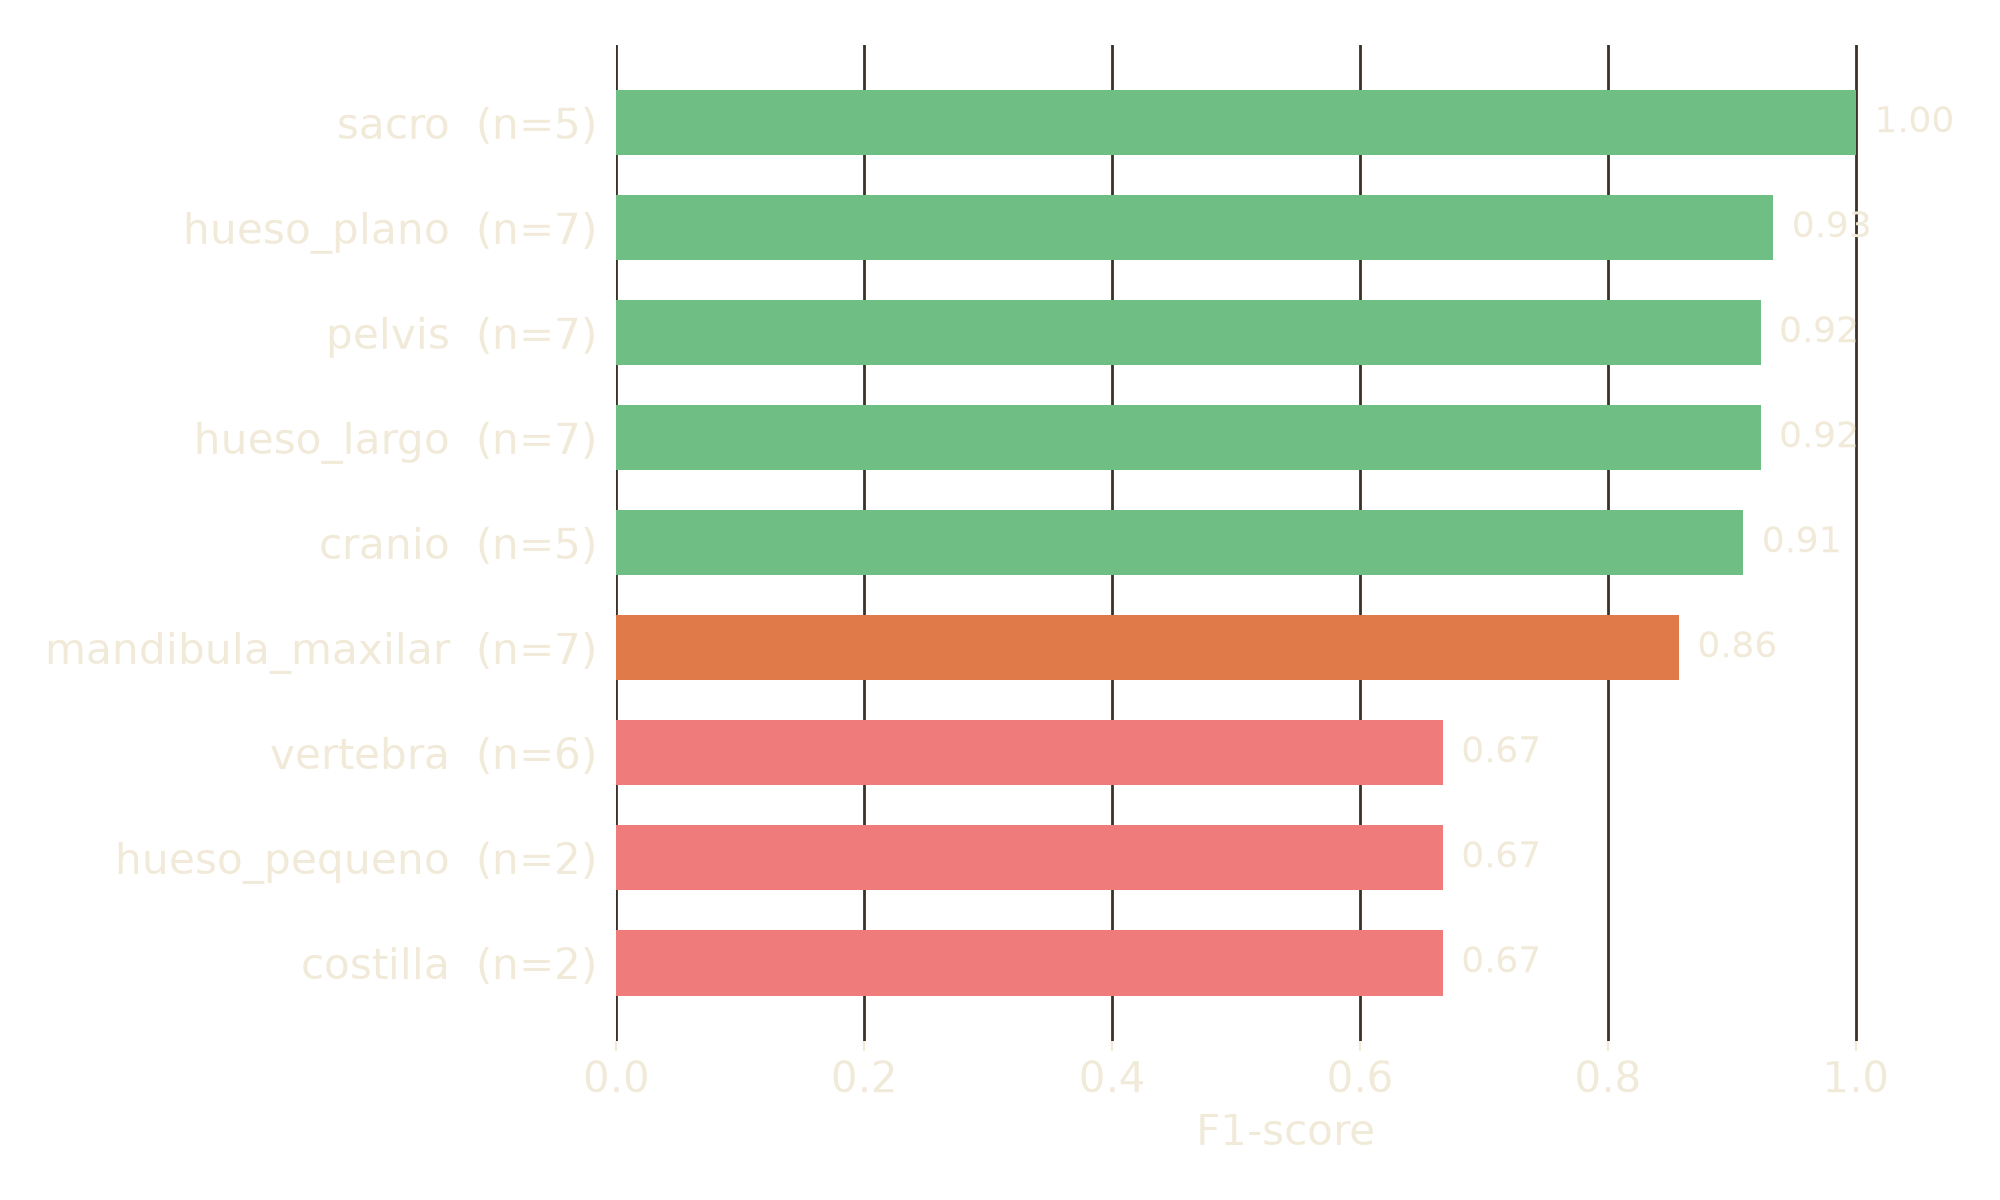
Matriz normalizada por clase real. Diagonal fuerte; n pequeño en costilla/hueso_pequeño (2 cada una) hace que un solo fallo pese 50%.F1 por grupo, peor a mejor. Las tres colas rojas tienen n=2 o n=6 — el dato que falta importa tanto como el modelo.
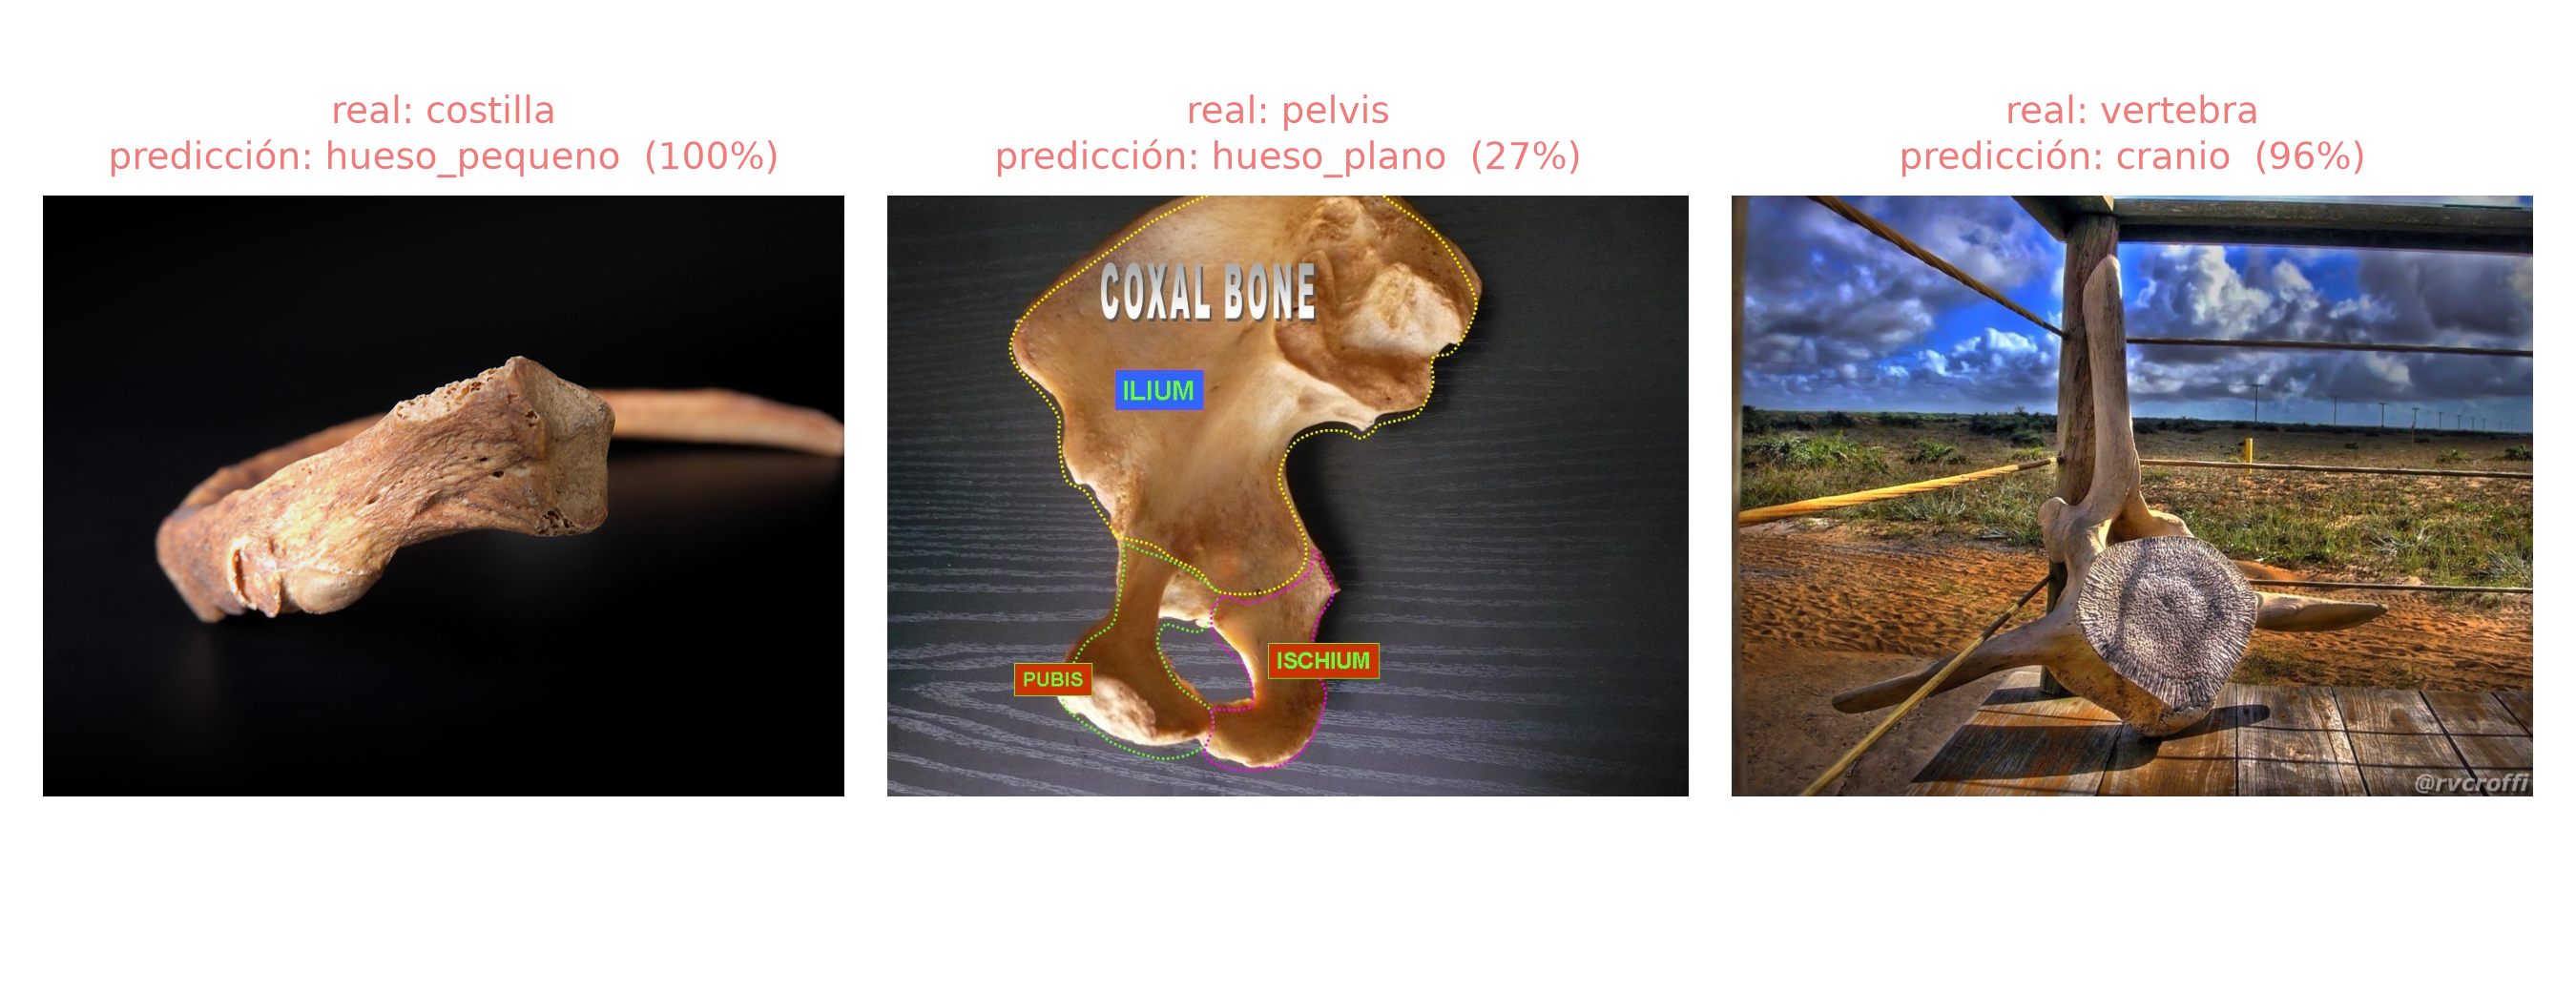
Tres fallos reales: dos con confianza alta (el modelo se equivoca seguro de sí mismo), uno con probabilidades casi empatadas (duda real).
¿Qué mejoró de verdad: datos, geometría o backbone?
Aislando cada pieza del sistema
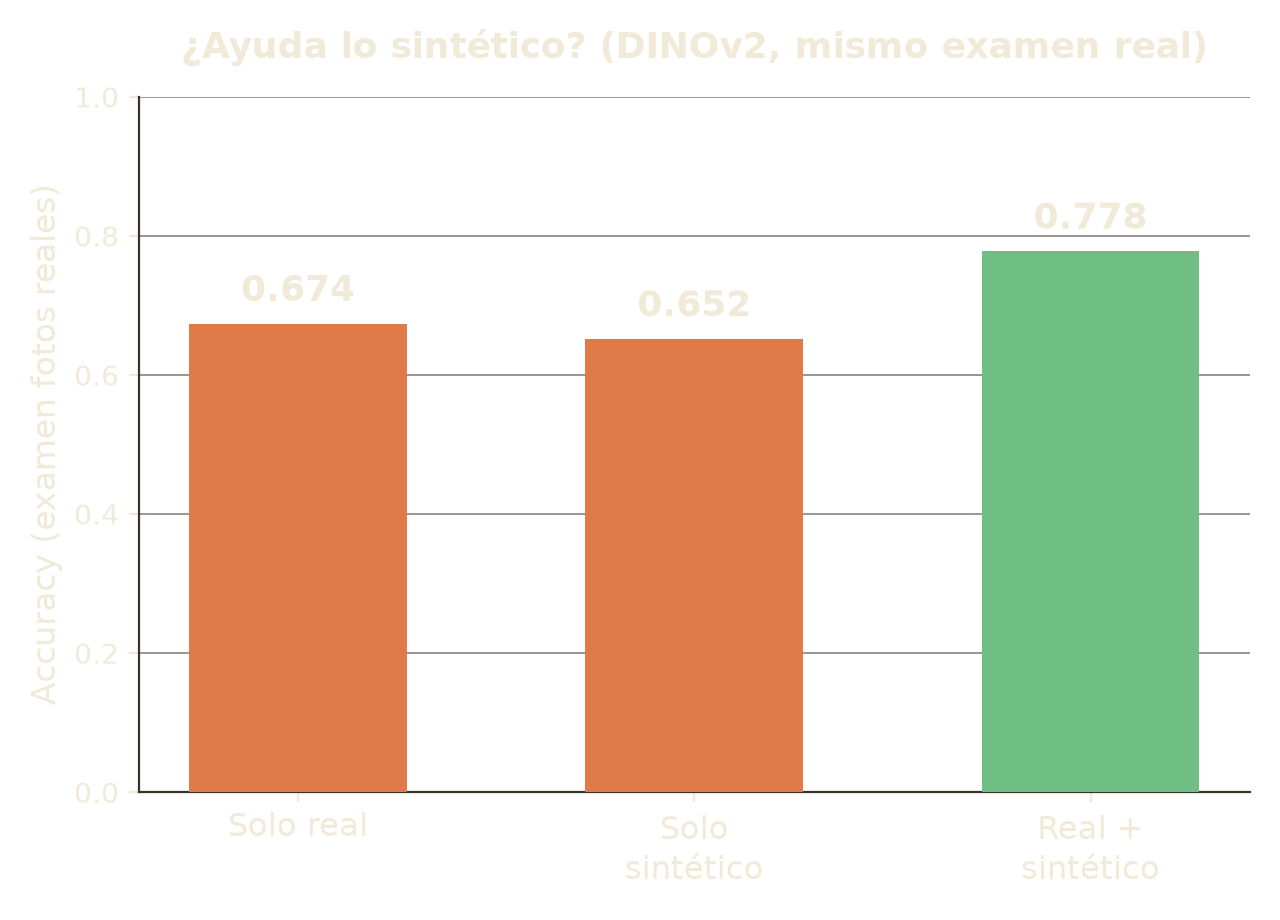
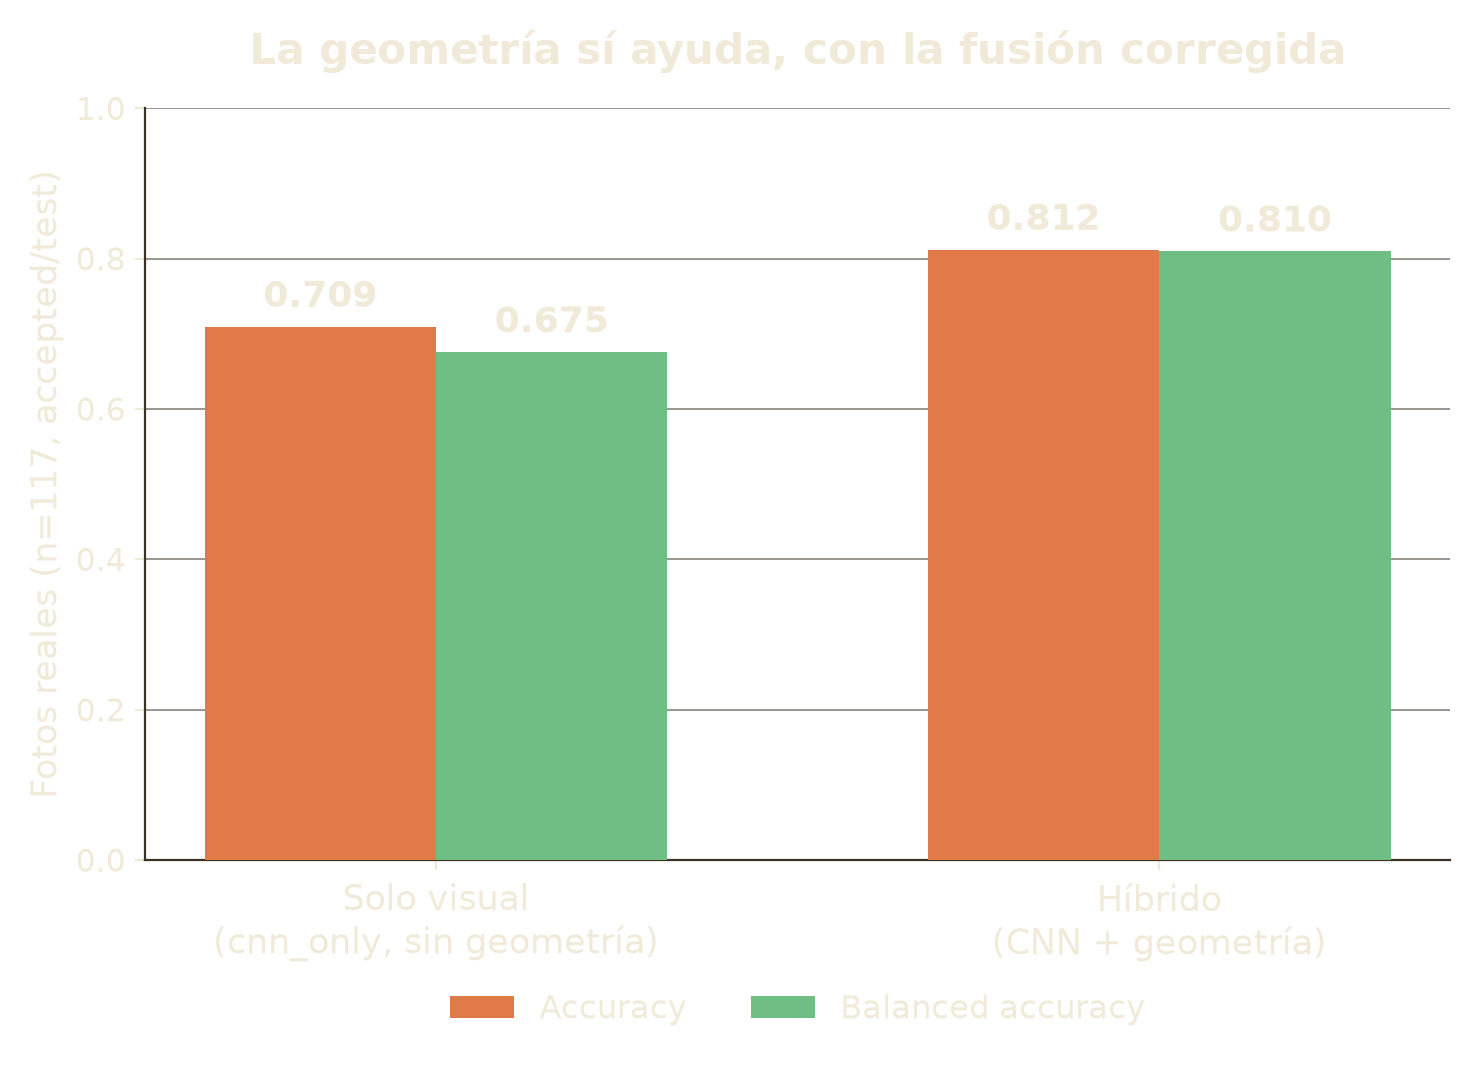
Mismo examen (fotos reales), DINOv2. Solo sintético no basta por sí solo, pero sumado a lo real sube 10 puntos sobre solo-real.Arquitectura actual (fusión corregida, no la naive que degeneraba en sacro): con geometría +10 puntos de accuracy y +13 de balanced accuracy sobre solo-visual, en 117 fotos reales.
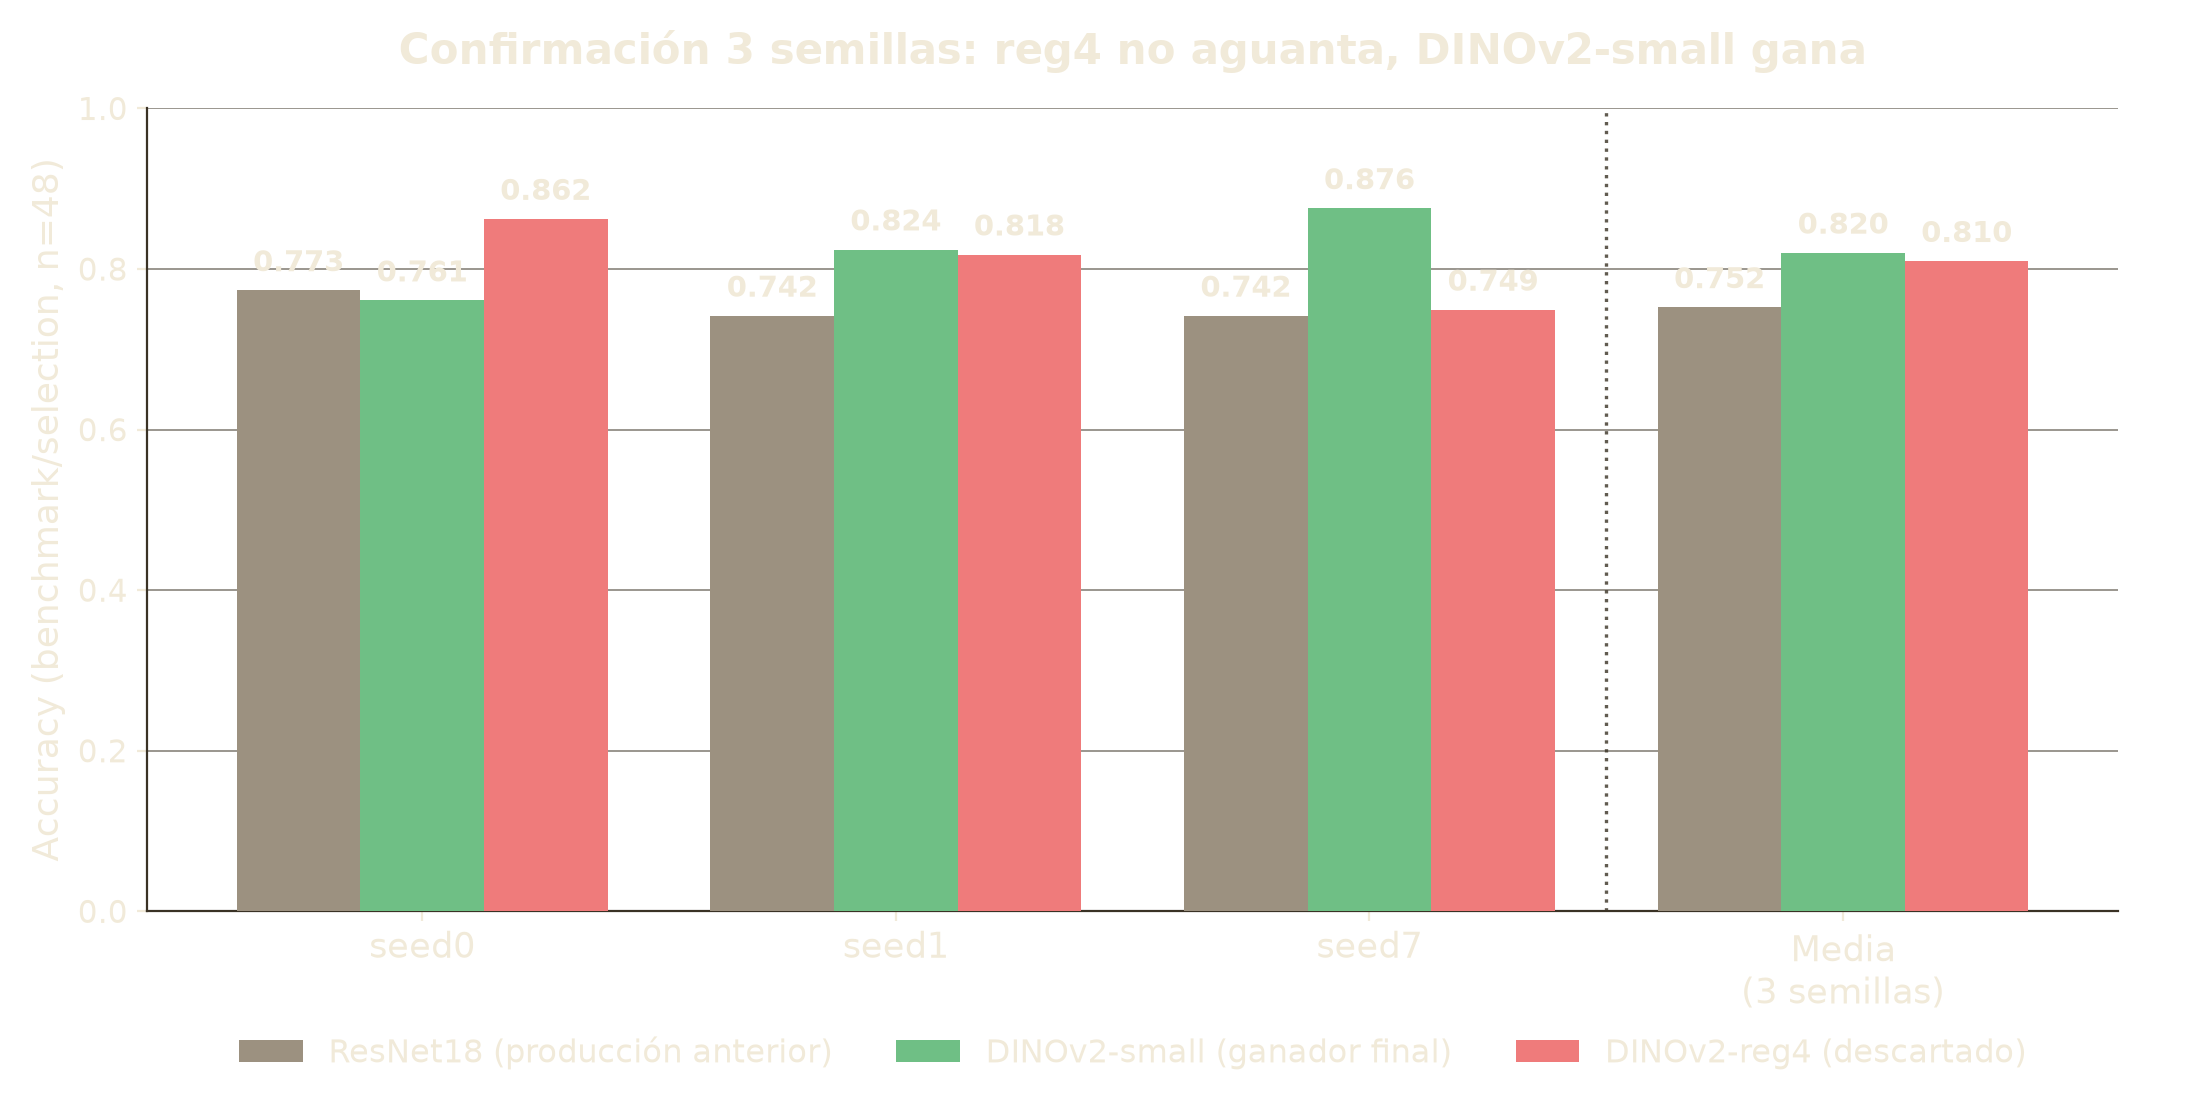
6 backbones, 1 semilla. DINOv2-reg4 (con "registers") parece ganar claro: +12.5 puntos sobre DINOv2-small normal.Con 3 semillas la historia cambia: reg4 cae a 0.810 (su seed0 era ruido de init), DINOv2-small normal gana con 0.820. Por eso no basta un solo run para decidir backbone.
Fusión (77 fotos reales)
Accuracy
Balanced acc.
Concatenación simple
0.844
0.796
Concat. + fondo negro
0.844
0.810
Puerta adaptativa
0.805
0.776
La puerta de fusión aprendida (gated) no supera a la concatenación simple — más complejidad, peor resultado. No se adoptó.
¿Hasta dónde podemos identificar un hueso?
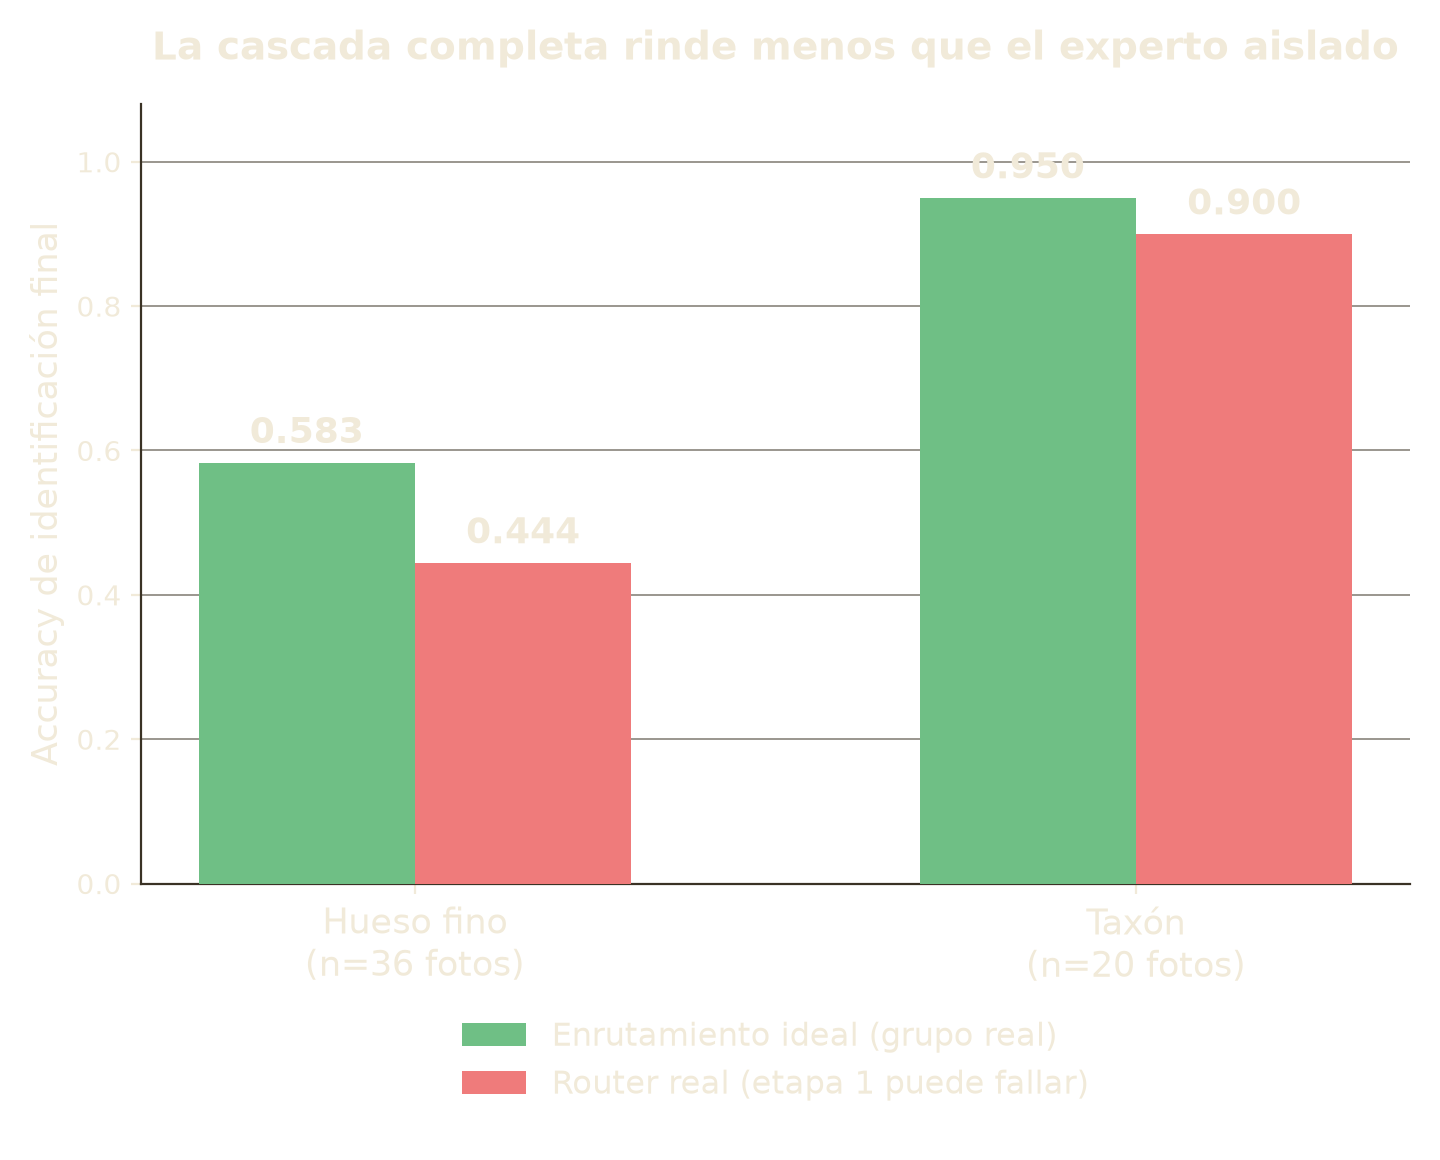
Los expertos van bien; el cuello de botella es el router
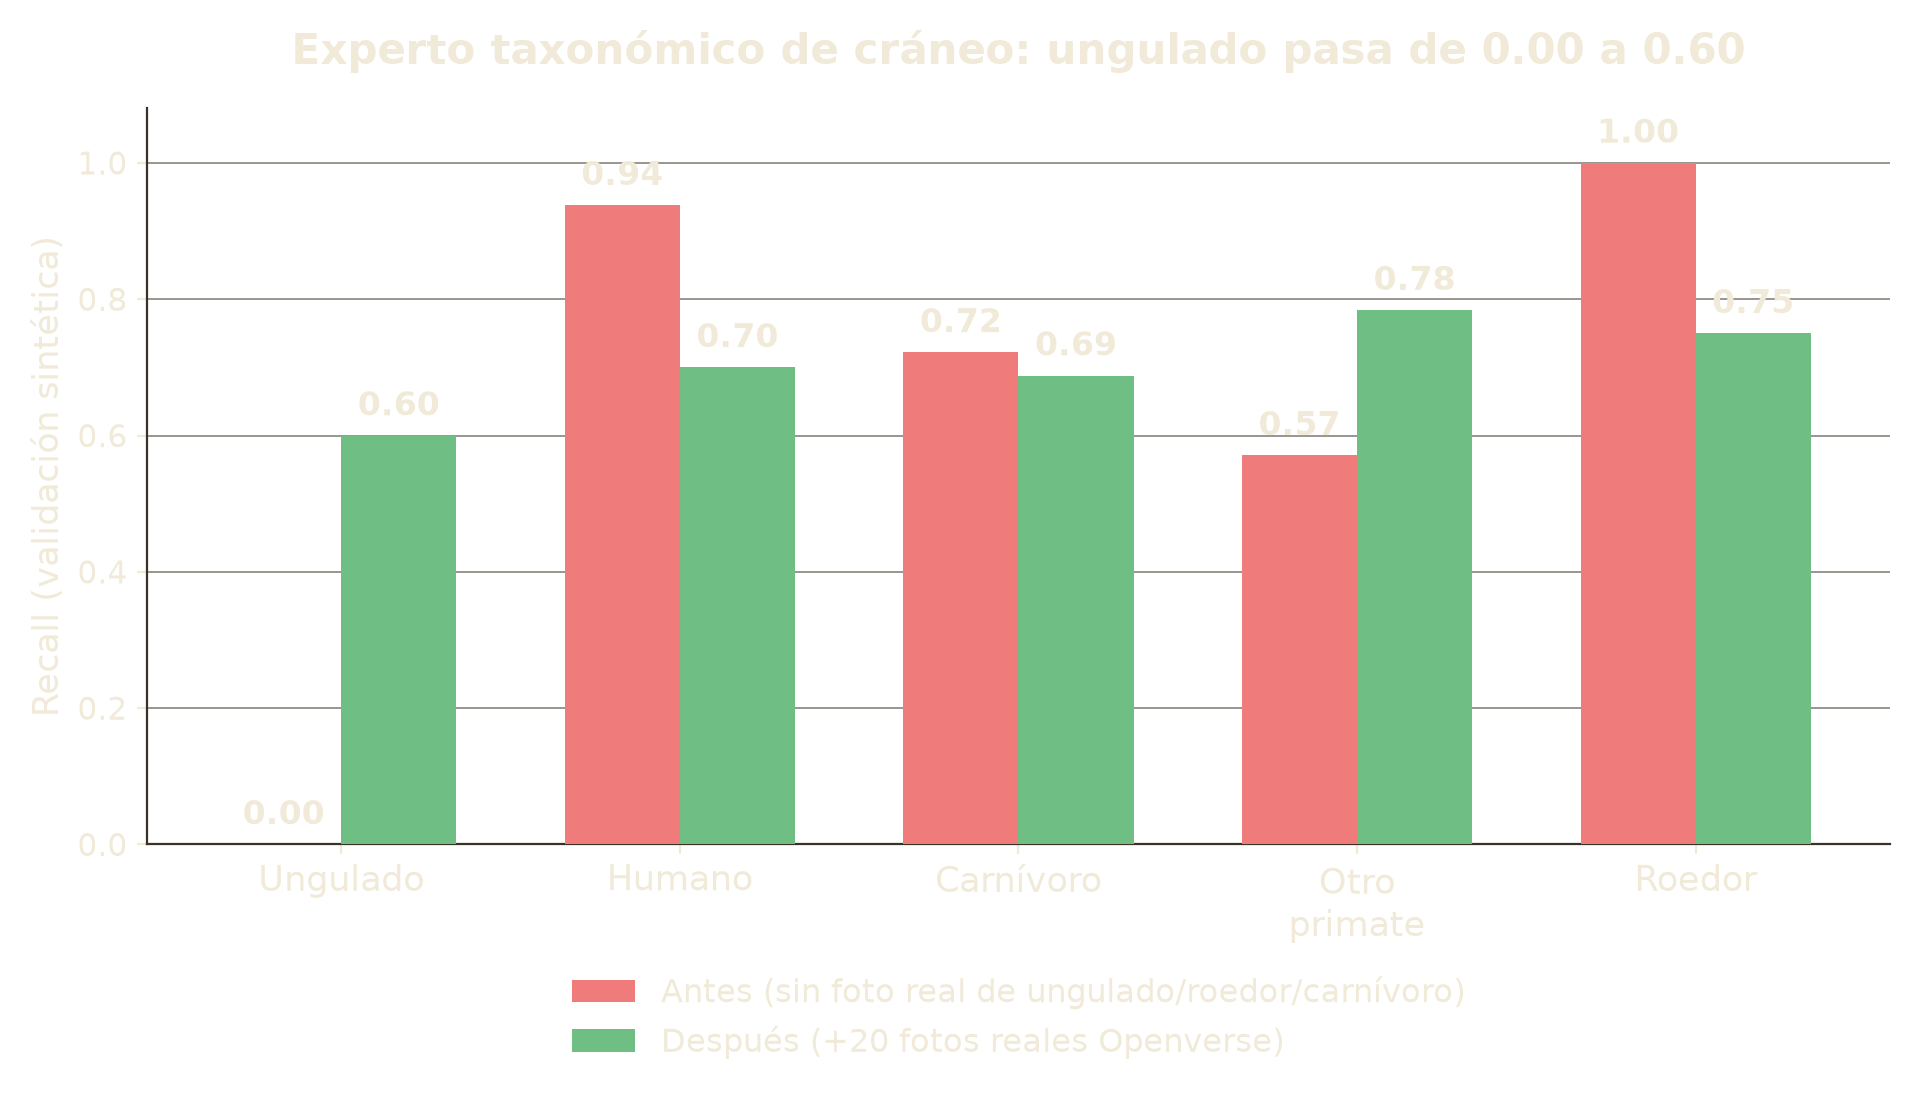
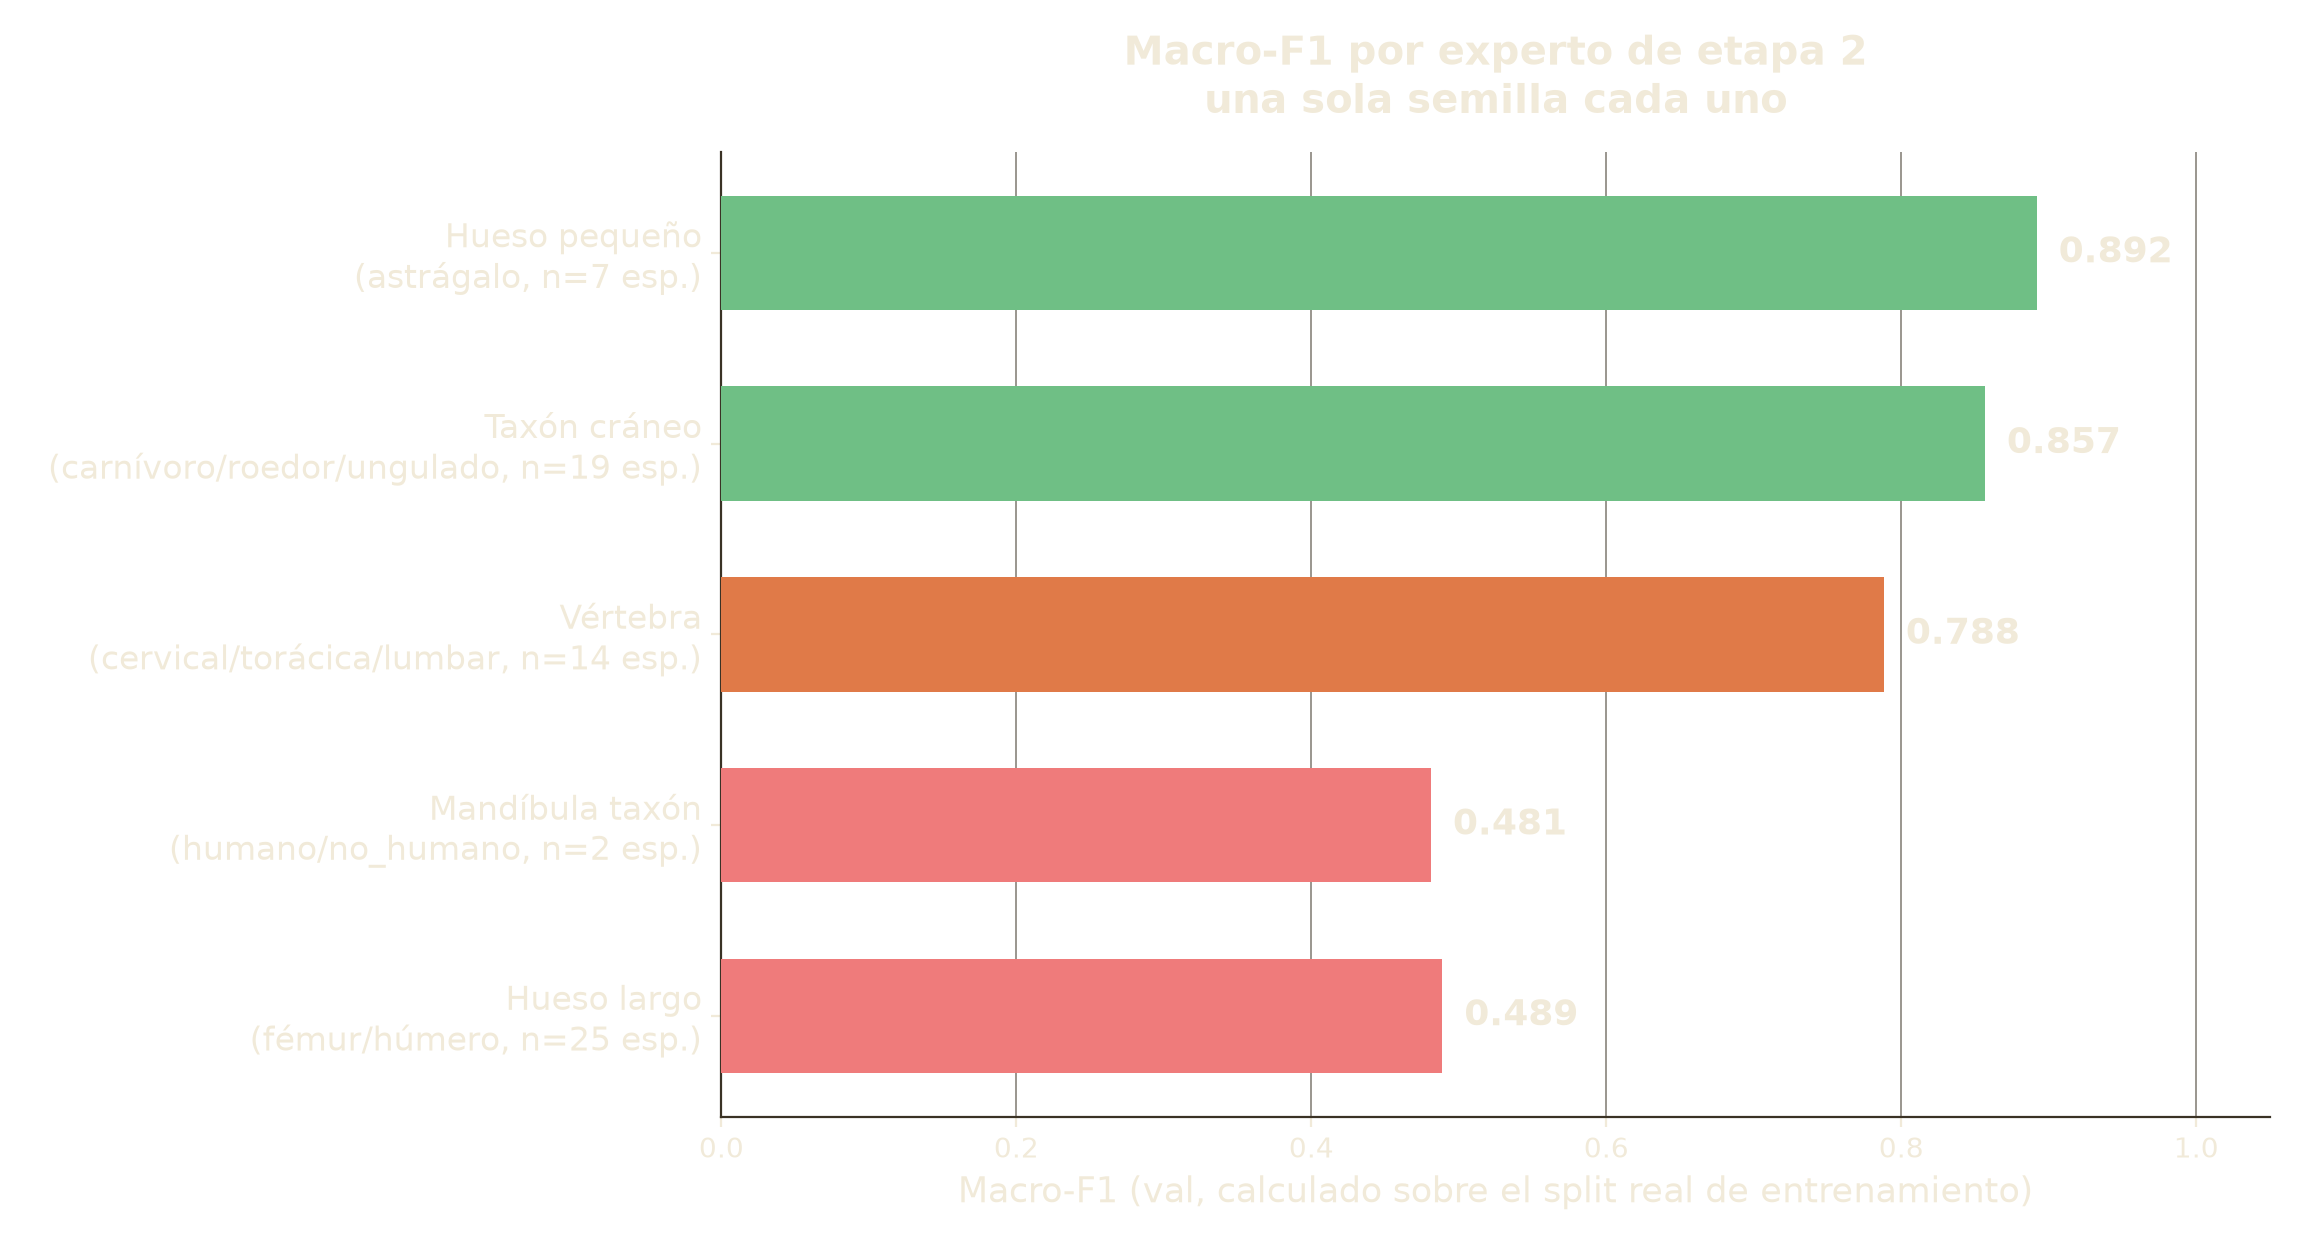
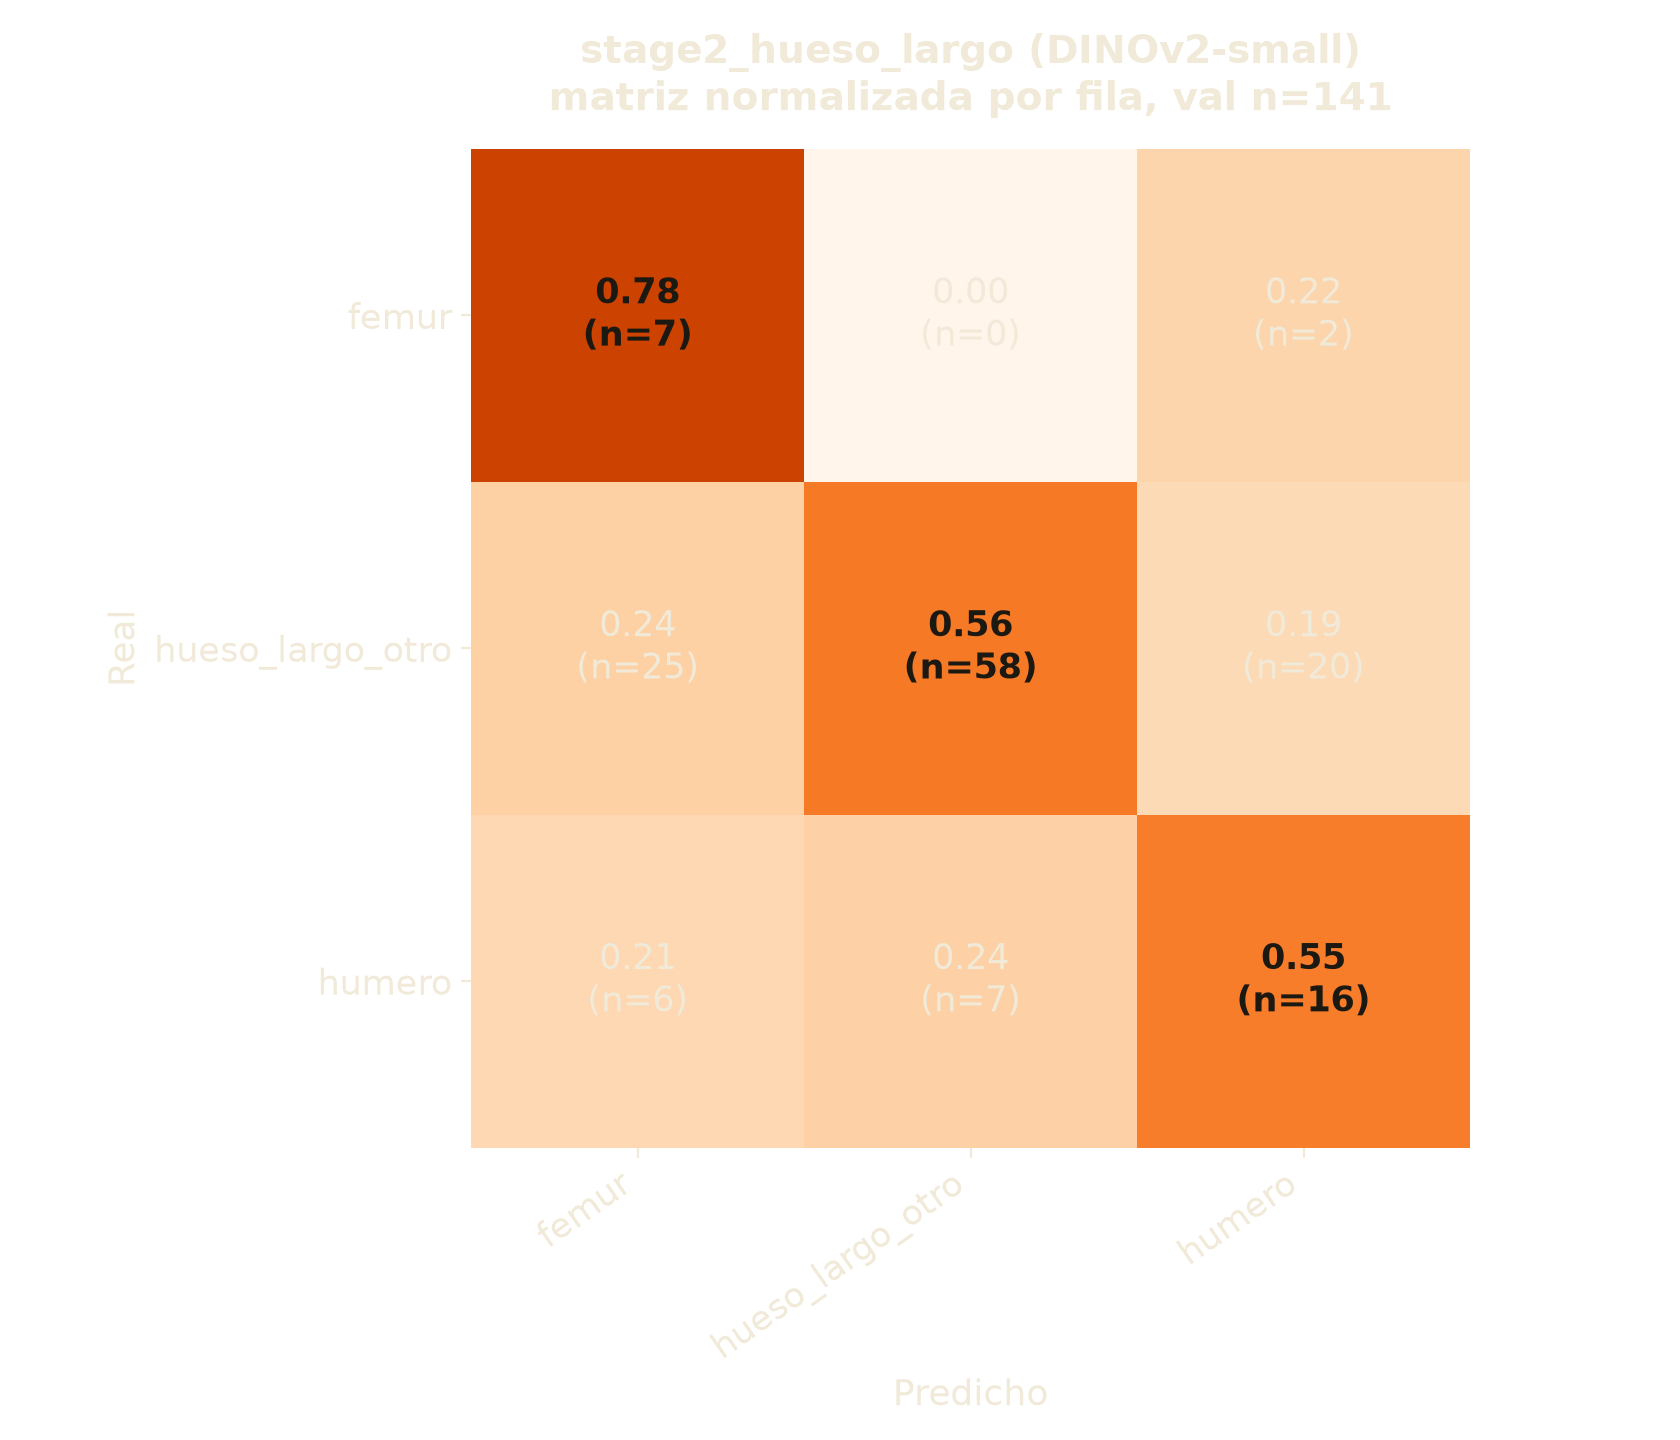
Taxón de cráneo. Ungulado sale del colapso (0.00→0.60), pero humano y roedor bajan — trade-off del guardarraíl anti-clase-cero, no mejora limpia.5 expertos, una semilla cada uno. Hueso pequeño y taxón cráneo rinden bien; hueso largo y mandíbula-taxón se quedan cortos — y estos dos últimos con n de especímenes muy bajo (25 y 2).
El experto peor evaluado del proyecto (macro-F1 0.49). Húmero y hueso_largo_otro se confunden casi por igual entre sí — la rama con menos datos de las cinco.Mismas fotos, dos pasadas: con el grupo óseo real (ideal) y con lo que predice el router de producción. El router de etapa 1 (resnet18) sigue siendo el cuello de botella de la cascada completa.
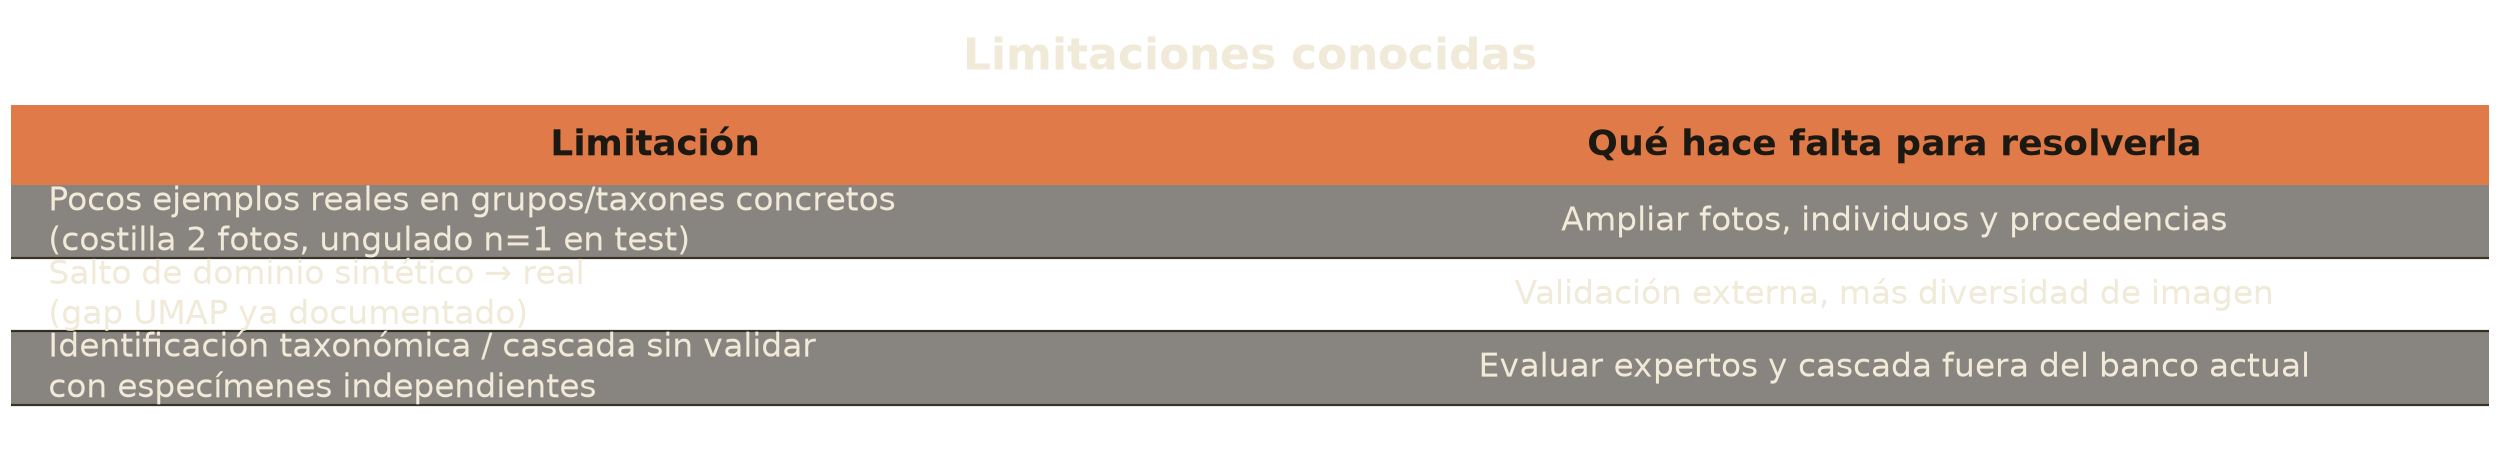
n=48 fotos reales con etiqueta fina/taxón (de real_photos_accepted/test) — es un subconjunto pequeño porque la mayoría del banco solo tiene etiqueta de grupo óseo, no hueso/taxón concreto. Confirma, con más dato que antes, lo que ya se veía con n=6: el router pierde más que los expertos.
¿Conseguimos lo que nos propusimos?
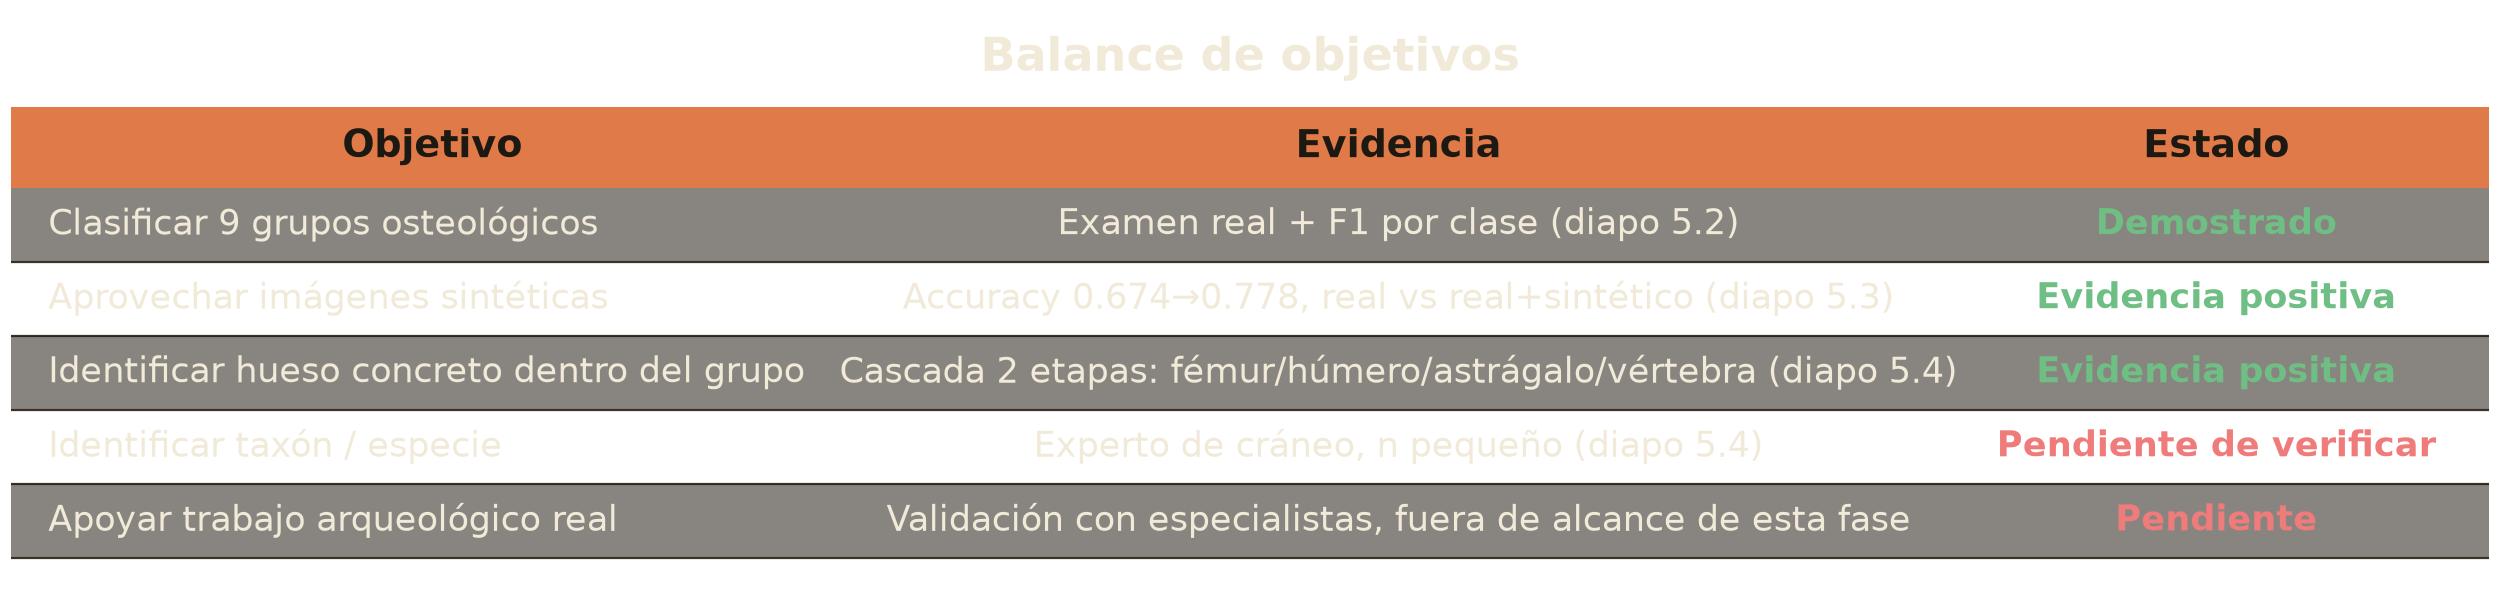
Balance honesto: demostrado, parcial, pendiente
9grupos osteológicos clasificados
+10,4puntos de accuracy al sumar fotos reales a lo sintético (DINOv2, mismo examen)
0,82accuracy media DINOv2-small, comparativa de backbones (examen distinto al anterior)
"Demostrado" = hay evidencia experimental de la capacidad, no que el sistema sea perfecto ni esté validado para un yacimiento concreto. Estados provisionales: este proyecto no tiene un documento formal de objetivos/criterios de aceptación de partida con el que contrastar.
Hemos demostrado la viabilidad de la clasificación osteológica asistida por datos sintéticos. El siguiente reto es validar su generalización, su precisión taxonómica y su utilidad en contextos arqueológicos reales.
La pregunta que guía el proyecto
No todo error se arregla optimizando
Antes de cambiar arquitectura o hiperparámetros, miramos qué clase de evidencia nos está dando el experimento.
🖼️
Falla en fotos reales pero aprueba renders
→
recoge fotos reales
✂️
Falla al recortar el objeto correcto
→
mejora segmentación
🦴
Una clase falla con todos los modelos
→
prioriza esa clase al curar
📏
La mejora cabe en el ruido del test
→
no promociones el cambio
Optimizar es una opción. Reformular, medir mejor, revisar imágenes y conseguir el dato que falta suelen ser decisiones más valiosas.
Resultado actual
Sobre 77 fotos reales que nunca vio
0.87accuracy
0.83balanced accuracy
3semillas, sin solape con el modelo anterior
✅ Muy bien
costilla, pelvis y sacro perfectos · hueso largo 0.94 · vértebra 0.89 · cráneo 0.86
⚠️ Todavía flojo
hueso plano (recall 0.25–0.67 según semilla): en 6 corridas, con 3 arquitecturas y 2 datasets. No es el modelo: faltan fotos reales.
Honestidad
Lo que no funcionó
✗
Mezcla de expertos con puerta aprendida (gated_hybrid): más parámetros, pérdidas auxiliares… y peor (0.805 vs 0.844).
✗
BlenderProc sustituyendo al render anterior: mejor en sintético, peor en real. Combinarlos sí ayudó.
✗
Elegir checkpoint con 12 fotos reales: el proxy subió, el examen bajó, y regaló una clase entera.
✗
Buscar "skull" en Openverse: diagramas, esculturas y… murciélagos llamados flying fox. Revisa antes de entrenar.
De notebook a servicio
Un proyecto de una persona, con MLOps de verdad
@app.post("/hybrid/classify")
async def hybrid_classification(file: UploadFile = File(...)):
    if not file.content_type.startswith("image/"):
        raise HTTPException(400, "El archivo debe ser una imagen")
    try:
        return classify_image_two_stage(file.file)
    except FileNotFoundError as e:   # modelo no entrenado
        raise HTTPException(503, str(e))

# la web de producto se sirve desde la misma app
app.mount("/", StaticFiles(directory=STATIC_DIR, html=True))
FastAPI API + webMLflow + Postgres, cada entrenamientoDVC datos versionados (6040 ficheros)Docker Compose./run.shStreamlit app "Tinder" de revisión de fotospytest + GitHub Actions
▶ Demo en vivoSube una foto → CLIP → geométrico + híbrido + VLM en paralelo
Para llevarse
Cinco lecciones que no dependen de los huesos
Diagnostica el cuello de botella antes de optimizar el modelo.
Sintético para arrancar, real para llegar. Unas pocas fotos reales valen oro.
Separa por sujeto, nunca por fila. Y que falle con excepción.
Balanced accuracy, varias semillas y test pareado antes de celebrar.
Mira tus datos. Visores y apps de revisión baratas encuentran lo que los tests no ven.
Gracias
¿Preguntas?
¿De quién es este hueso? — OsteoLab
Francisco Javier Luengo GutiérrezArqueólogo y Machine Learning Engineer
Slides y demo en esta misma web · 2026.es.pycon.org