Metodología
El proyecto contado como CRISP-DM
Arquitectura explica cómo funciona el sistema hoy, paso a paso, cuando llega una foto. Esta página cuenta lo mismo desde otro ángulo: el proceso que siguió el proyecto para llegar hasta ahí, usando las 6 fases del marco CRISP-DM (Cross-Industry Standard Process for Data Mining) — el esquema estándar para proyectos de ciencia de datos desde los años 90, todavía el más usado en la industria. No es lineal en la práctica: hay vueltas atrás constantes entre fases (de "Evaluación" a "Preparación de datos", sobre todo), pero sirve como mapa.
Fase 1
Comprensión del negocio
El objetivo no es "identificar el hueso exacto" ni sustituir a un osteólogo — es dar una primera clasificación rápida por grupo morfológico (cráneo, hueso largo, vértebra...) a partir de una foto, útil para laboratorio, docencia o una criba inicial antes de la revisión experta. De ahí sale la decisión clave de todo el proyecto: la taxonomía son 9 grupos de forma, no 21 huesos exactos ni especies — con 1-9 especímenes físicos por hueso, pedir más granularidad hace que el modelo memorice objetos concretos en vez de aprender formas (comprobado con especímenes completos fuera de validación, no solo fotos sueltas).
Restricción que viene de aquí y condiciona todo lo demás: no hay presupuesto para fotografiar miles de huesos reales. Esa única restricción de negocio es la que obliga a generar datos sintéticos a partir de modelos 3D (fase 2) y a resolver después el problema sim2real (fases 3-5).
Fase 2
Comprensión de los datos
No existe un data/raw/<clase>/ con miles de fotos. Lo que hay es un
catálogo de mallas 3D verificadas a mano, varias recetas de render con distinto nivel de
realismo, y un puñado de fotos reales curadas. Ver la carpeta de cada fuente, imagen por
imagen, es el primer paso para entender qué se le está dando de comer al modelo —
exactamente lo que se ve abajo.
Las carpetas de datos, de verdad
Mismo espécimen (fémur de gorila) a través de las tres recetas sintéticas, más una foto real de otro grupo para comparar contra el objetivo final. Clic para ampliar.
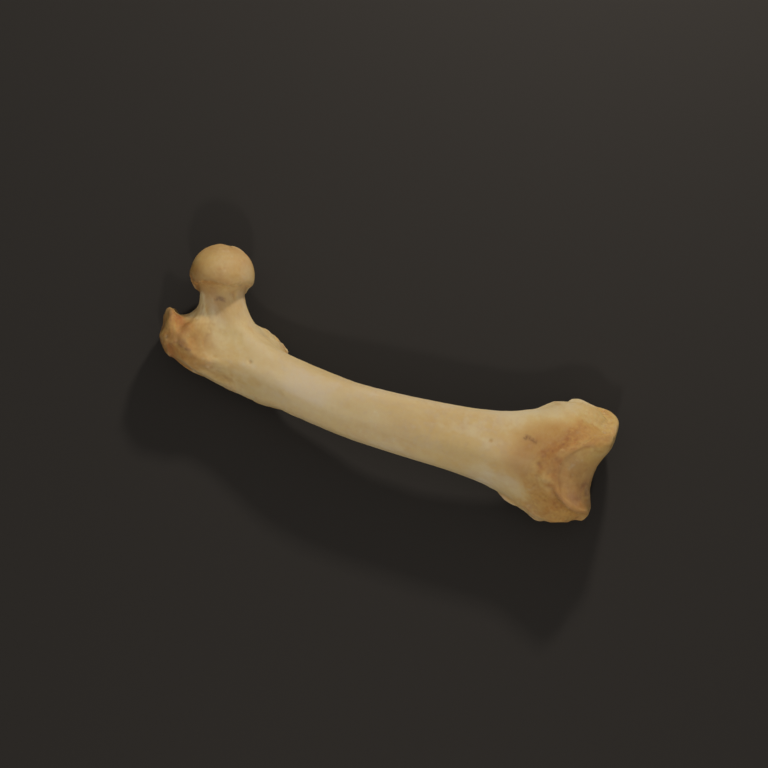
renders_lab/ — escena de laboratorio: el hueso cae físicamente sobre
una mesa, HDRI real, material multicapa de 6 capas (bone_material.py).
La receta más realista de las tres, y la base del dataset de producción.
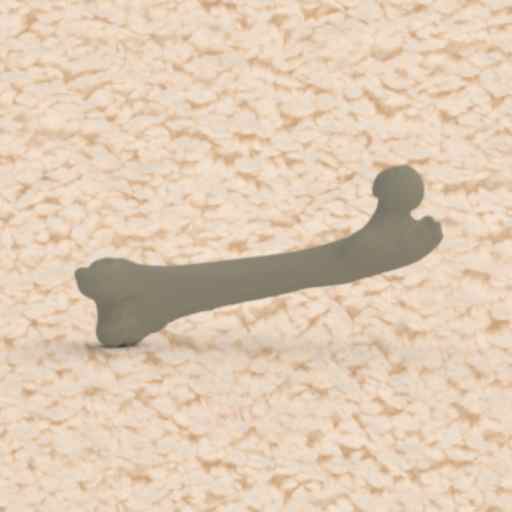
renders_noisy_composited/ — silueta sin material realista, pegada
sobre una foto de fondo real. Pose de órbita fija, no física — distinta a la de
renders_lab para el mismo objeto.
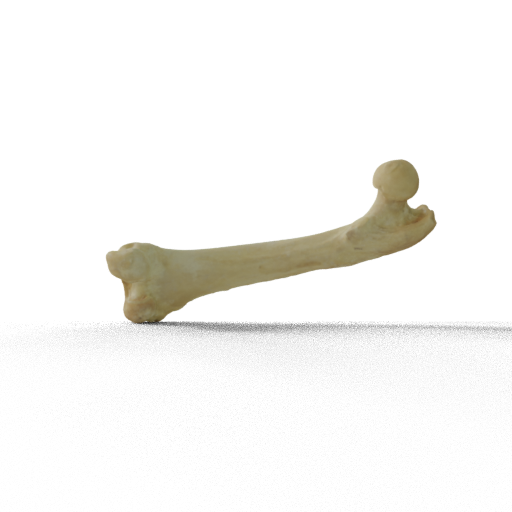
renders_noisy_bproc/ — BlenderProc: HDRI real, suciedad procedural,
máscara ground-truth exacta. Otra órbita fija distinta, material más simple que
renders_lab.
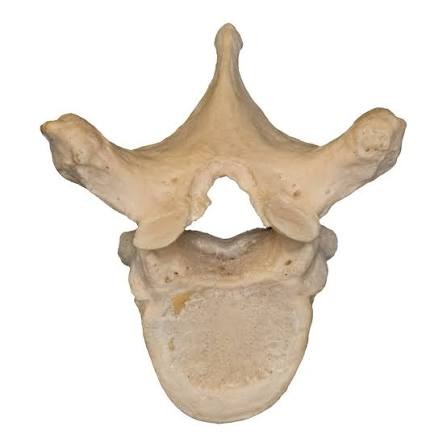
Fotos entrenamiento/_curated/ — hueso real fotografiado y revisado a mano. Pocas, pero son el dominio que de verdad importa: el examen final siempre se hace aquí, nunca solo contra sintético.
Un ejemplar de cada grupo morfológico (renders_lab)
Los 9 grupos que aprende el modelo, cada uno con su imagen de ejemplo real del dataset de producción.
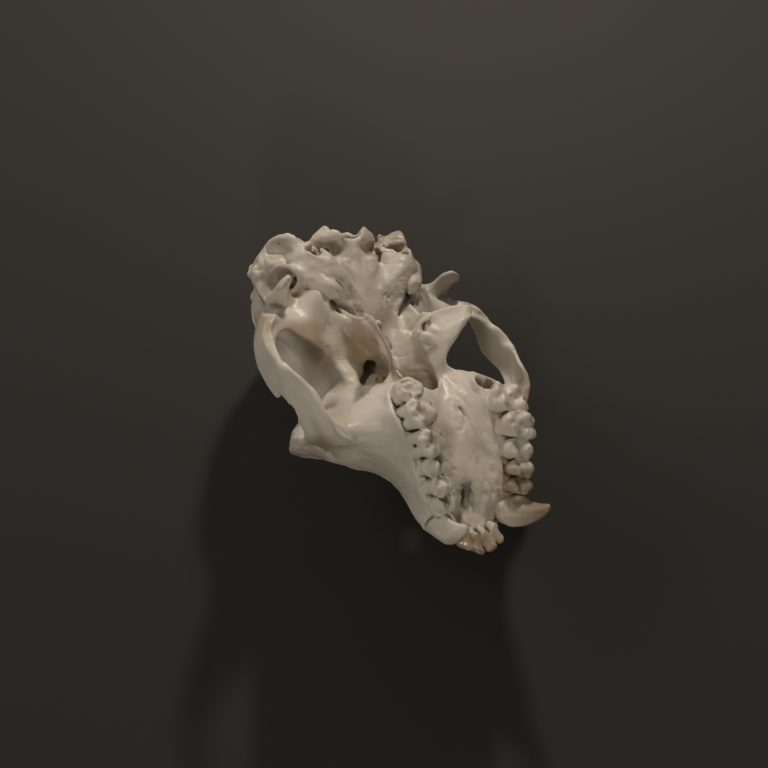
cráneo
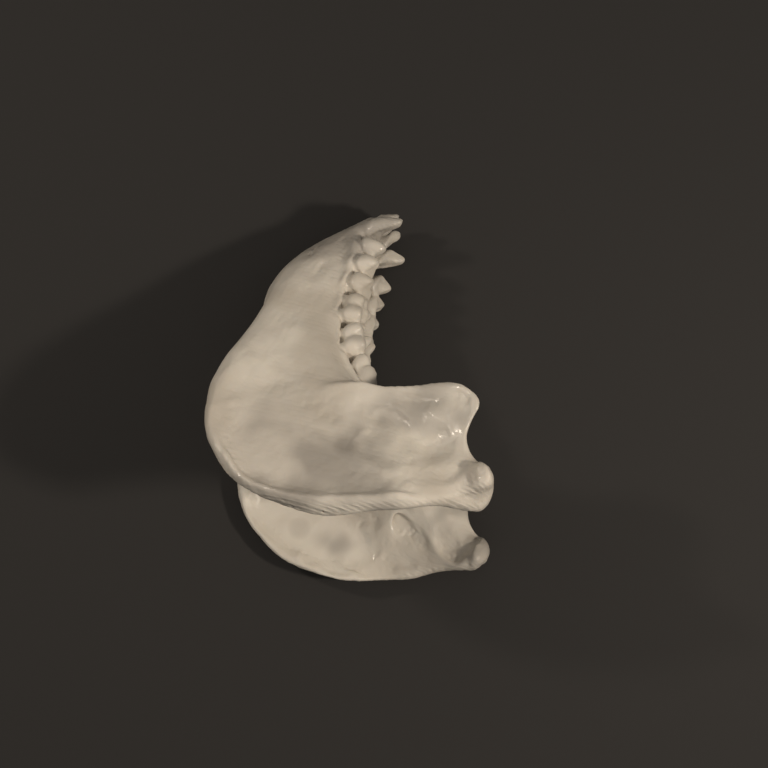
mandíbula / maxilar
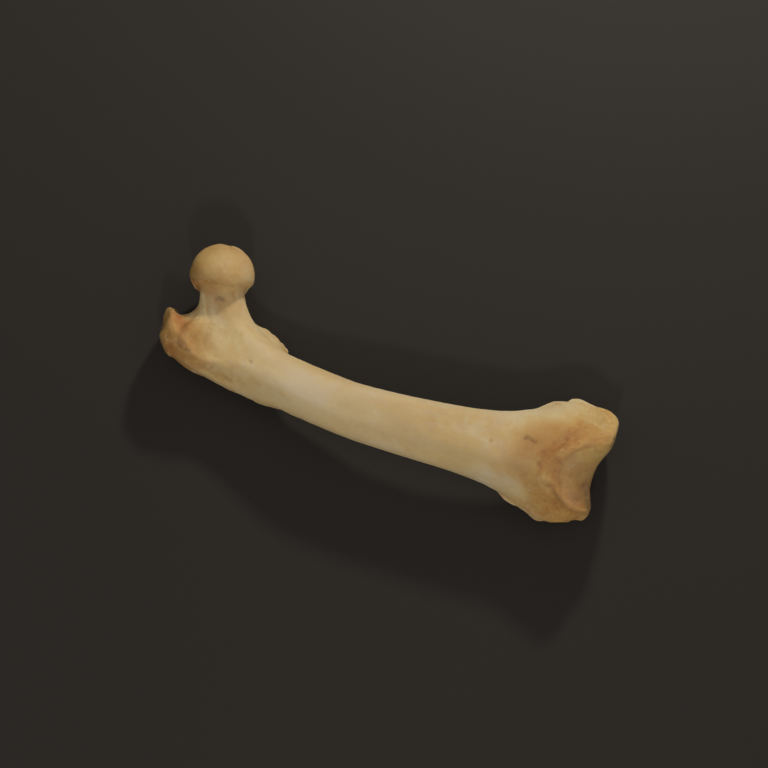
hueso largo
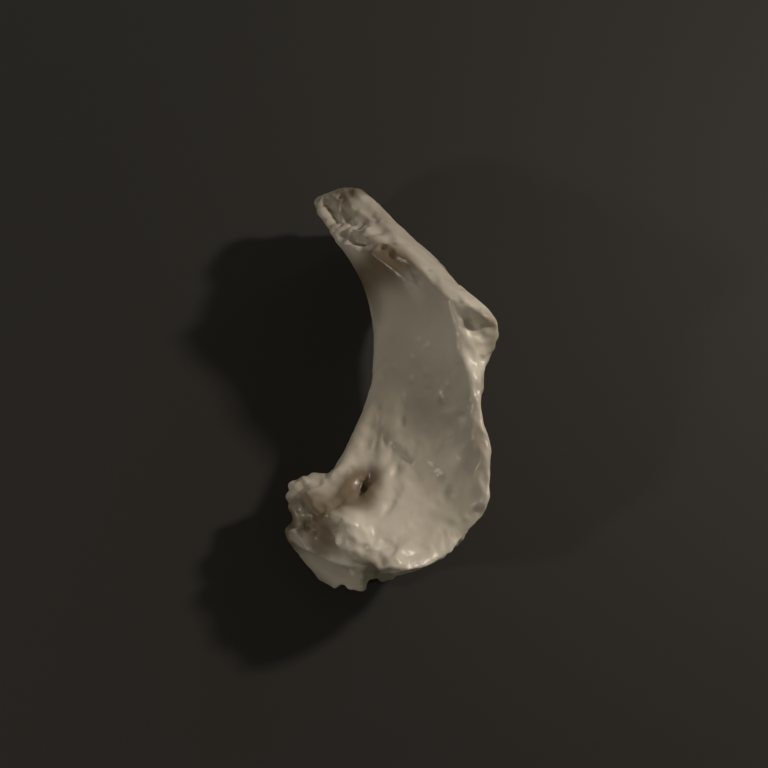
hueso plano
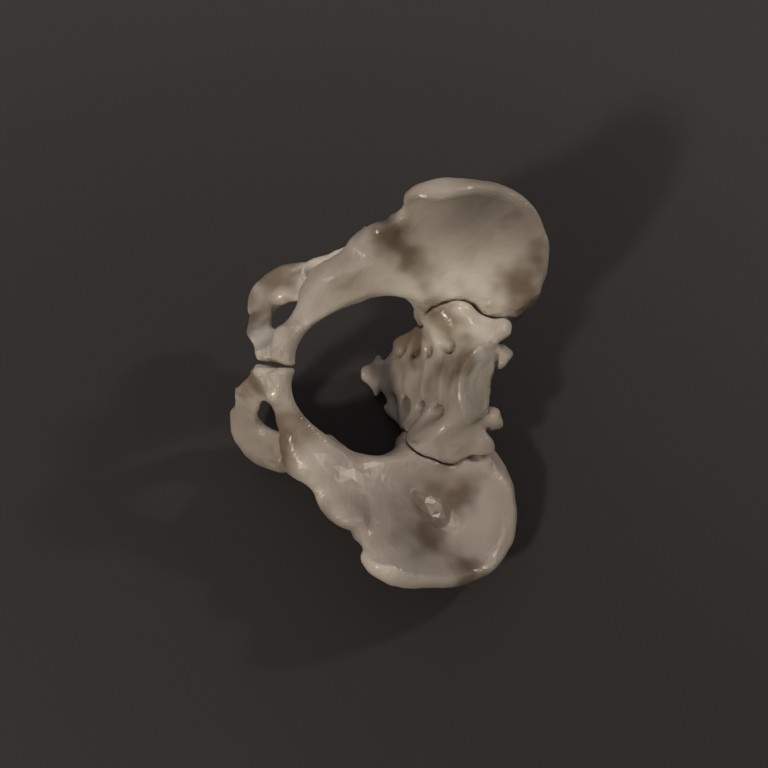
pelvis
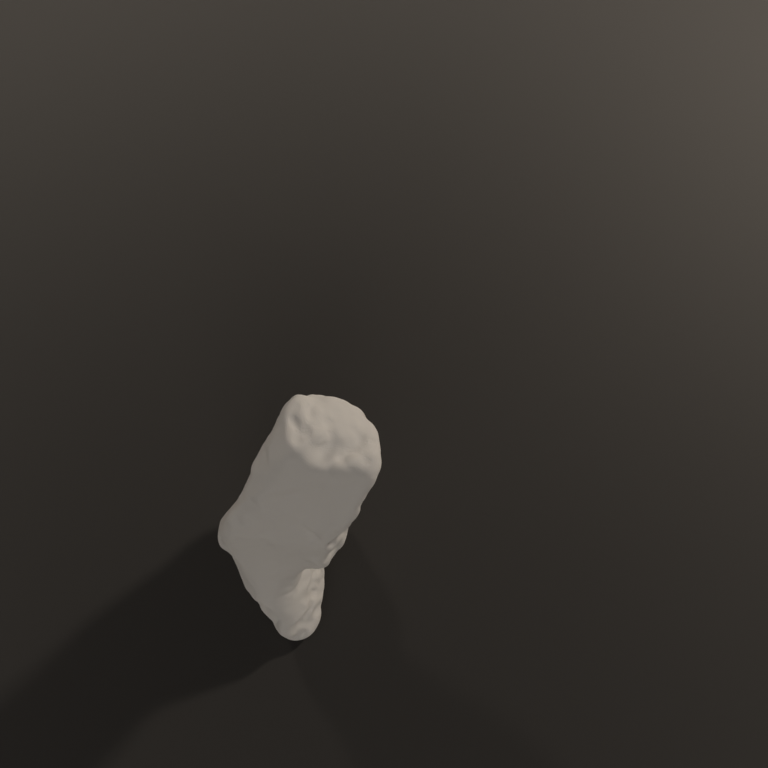
sacro
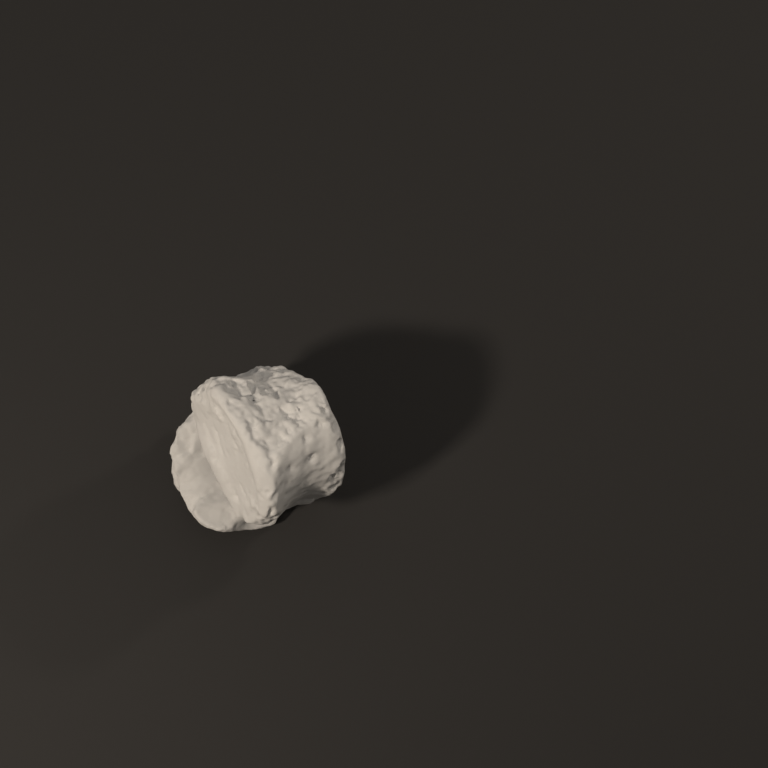
vértebra
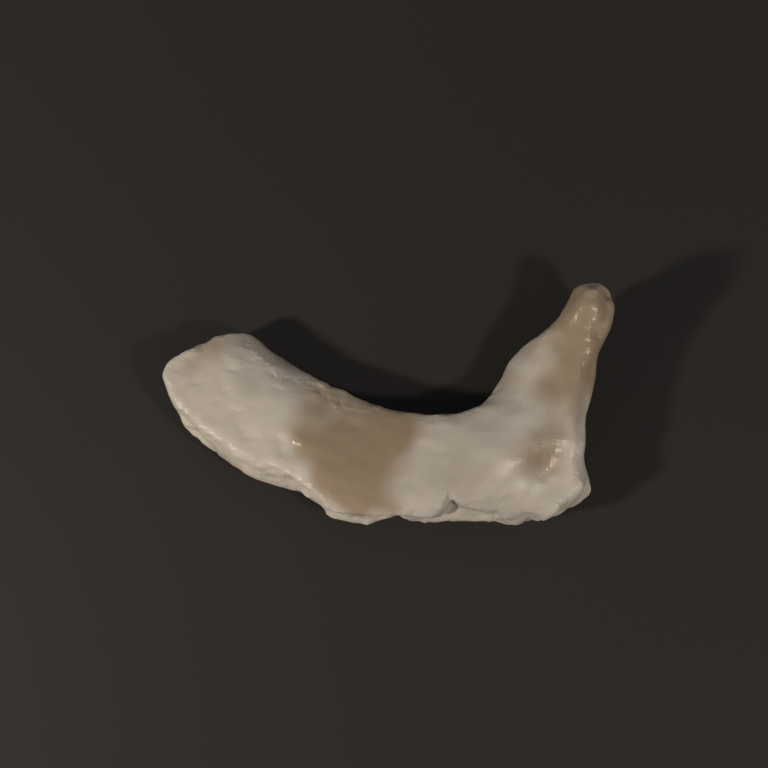
costilla
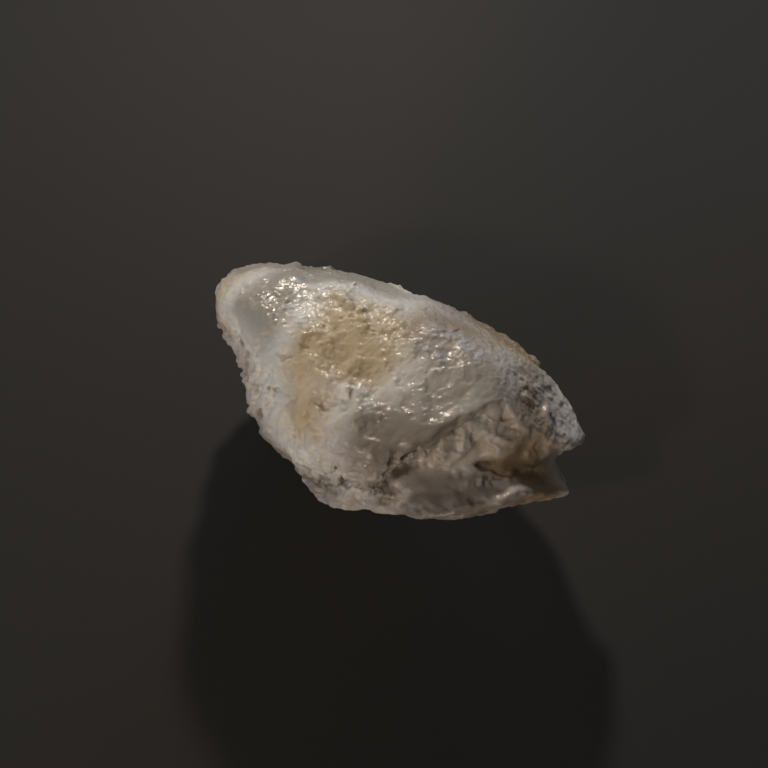
hueso pequeño
Vista completa navegable con miniaturas de todas las carpetas (mallas, cada generación de render, fotos reales, recortes segmentados): 📁 Ver "Datos" completo →
Fase 3
Preparación de datos
Cada imagen se mide con shared/cv_extractor/extract.py (geometría clásica:
elongación, circularidad, momentos de Hu, perfil de anchura...) y se vuelca en una tabla.
El dataset de producción, bone_geometric_features_combined_lab.csv, mezcla
renders_lab + noisy_composited + noisy_bproc +
fotos reales de entrenamiento: 2938 filas.
combined_lab)
Regla fija para evitar fuga: un conjunto de especímenes completos se reserva entero para
banco de evaluación y nunca entra en entrenamiento (24 vistas del mismo objeto no se
reparten entre train y test). Detalle completo, paso a paso y ejecutable, en
notebooks/pycon26_01_preparacion_datos.ipynb.
Fase 4
Modelado
Dos modelos sobre los mismos datos: un Random Forest sobre las features
geométricas (clásico, interpretable), y una CNN híbrida (recorte de
imagen + vector geométrico, transferencia de aprendizaje sobre resnet18).
El modelo en producción es hybrid_lab.
Ablación: ¿aporta algo el vector geométrico?
Entrenados cnn_only y hybrid con receta idéntica (mismo
dataset, misma semilla) y evaluados en el banco grande de fotos reales (117 fotos,
dominio nunca visto en entrenamiento):
| Modelo | Banco sintético fijo | Fotos reales (n=117) | Balanced accuracy |
|---|---|---|---|
cnn_only (sin geometría) | 0.4815 | 0.7094 | 0.6755 |
hybrid (con geometría) | 0.5972 | 0.8120 | 0.8098 |
+10 a +13 puntos con geometría, en ambos dominios. El vector geométrico se queda en producción — no es un accesorio, es la diferencia entre 0.71 y 0.81 de accuracy en el dominio que de verdad importa.
Fase 5
Evaluación
Tres bancos, de más fácil a más difícil — solo el último cuenta como resultado real: validación interna → banco sintético con especímenes excluidos → banco de fotos reales. Si un cambio mejora el banco 2 y empeora el 3, es mala señal: el modelo se está ajustando a particularidades del render, no a la forma real del hueso.
Caso de estudio en vivo: una intuición razonable que falló al medirla
Durante la preparación de esta charla se notó que noisy_composited y
noisy_bproc repiten casi los mismos especímenes que ya están en
renders_lab (112/113 y 90/91 coinciden). Parecía una limpieza obvia:
quedarse solo con renders_lab + fotos reales. Se probó de verdad:
| Dataset | Filas | Banco sintético fijo | Fotos reales (n=117) | Balanced accuracy |
|---|---|---|---|---|
combined_lab (3 variantes + reales, producción) | 2938 | 0.5972 | 0.8120 | 0.8098 |
combined_lab deduplicado (solo renders_lab + reales) | 1447 | 0.5463 | 0.6923 | 0.7280 |
Empeoró 12 puntos. No había fuga (el split separa especímenes completos,
verificado en código) — el motivo real es que cada receta usa una pose física
distinta (caída real en renders_lab vs. órbita fija en las otras
dos) y un material distinto: no es duplicación cosmética, es variación visual legítima
que ayuda a generalizar a fotos reales. Se revirtió el cambio y quedó documentado en
base_datos_osea/HISTORIAL.md (2026-10-30).
Segundo intento: más poses dentro de renders_lab, sin pedir prestado
Si renders_lab es la receta de mejor acabado, ¿generar poses nuevas ahí
mismo (física real, otra semilla) en vez de mezclar recetas de menor calidad para ganar
volumen? Renderizados 189 especímenes × 6 vistas nuevas (1134 imágenes), dataset de
2527 filas (renders_lab + poses nuevas + reales, sin las otras dos recetas):
| Dataset | Filas | Banco sintético fijo | Fotos reales (n=117) | Balanced accuracy |
|---|---|---|---|---|
combined_lab (3 variantes + reales, producción) | 2938 | 0.5972 | 0.8120 | 0.8098 |
combined_lab + poses nuevas (renders_lab + extra + reales) | 2527 | 0.5185 | 0.7607 | 0.7404 |
combined_lab lab + bproc (sin composited) | 1861 | 0.5324 | 0.7265 | 0.7471 |
combined_lab deduplicado (solo renders_lab + reales) | 1447 | 0.5463 | 0.6923 | 0.7280 |
Mejora sobre el dedup (+6.8 puntos) pero sigue por debajo del original (-5.1 puntos). Parte del problema del dedup era volumen/pose, pero no todo.
Un fondo que la CNN nunca llega a ver
Hipótesis inicial: noisy_composited ayudaba por el fondo fotográfico real
pegado detrás del hueso. Al mirar el recorte segmentado real que recibe la CNN (no la
imagen completa, el crop_image ya aislado) se descubrió que es falso — el
fondo se recorta siempre a gris neutro, la red nunca lo ve:
renders_lab, imagen completa — material con textura real.
noisy_composited, imagen completa — silueta plana sobre fondo fotográfico.
Tras segmentar y recortar (lo que de verdad entrena la CNN), el fondo desaparece en los
dos casos y lo único que queda de noisy_composited es una silueta casi sin
textura. Lo que sí aporta esa receta: no tiene máscara ground-truth, así que se segmenta
con grounded_sam — el mismo método (con su mismo ruido de contorno) que se
usa en producción sobre fotos reales — y una pose de cámara distinta a las otras dos
recetas. Patrón que se repite en los cuatro experimentos: ninguna pieza individual (pose,
ruido de segmentación, acabado de material) explica la mejora por sí sola, es la
diversidad combinada de las tres. Producción no cambia:
sigue hybrid_lab, 3 variantes + reales. Los cuatro modelos quedan en
MLflow/DVC como referencia, ninguno promovido.
Fase 6
Despliegue
El modelo entrenado no es el final — se sirve en una cascada de dos etapas
(ver Arquitectura para el diagrama completo) detrás de
una API FastAPI, con reproducibilidad real: cada entrenamiento y evaluación queda
registrado en MLflow, cada artefacto grande (modelos, datasets de
imagen) en DVC, cada decisión y su motivo en
HISTORIAL.md, y el código en git. Nada queda solo en el disco de una
máquina.
dvc push